一个 Key 调所有模型:5 种写法与 404 陷阱
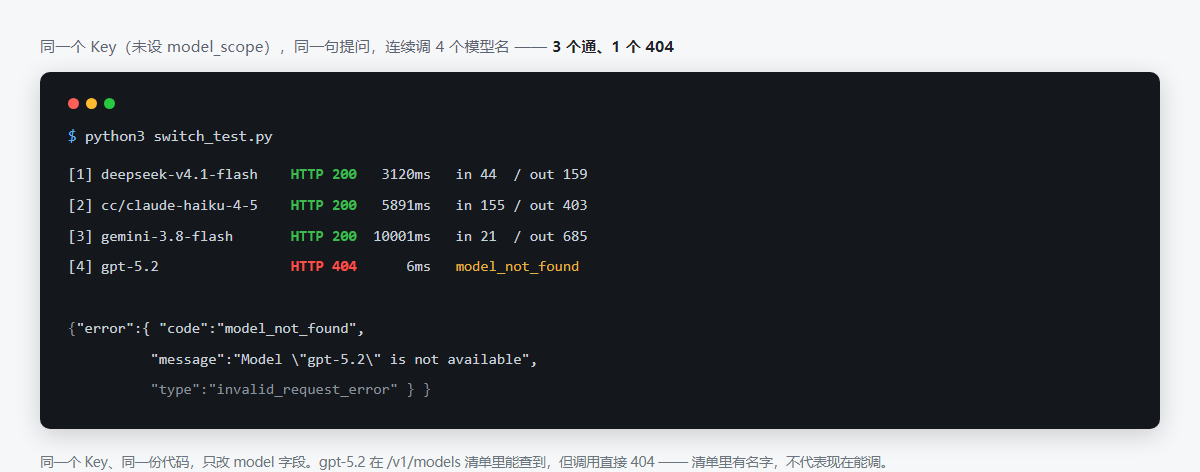
先说结论:一个 Key 确实能调所有模型,但真正卡住人的不是 Key,是名字。我拿同一个 Key 对着 4 个模型名连打了一遍,3 个通、1 个 404——而那个 404 的名字,就明明白白写在 /v1/models 的返回里。
下面全是实测:命令、账单、报错原文。就算你用的不是我们的服务,换成别家 API 中转站,判断方法也一样。
一、清单里有名字,不等于现在能调
先用一个 Key 拉模型清单,返回 805 个 ID(2026-11-03 实测)。而模型广场首页写的是「190 个模型,935 条货源,一个密钥」。
两个数差 600 多,原因有两类:一是同一个模型挂在不同上游,会各占一个名字(下文第二节就是证据);二是清单里还混着图片、语音这类不在广场文本区的型号。
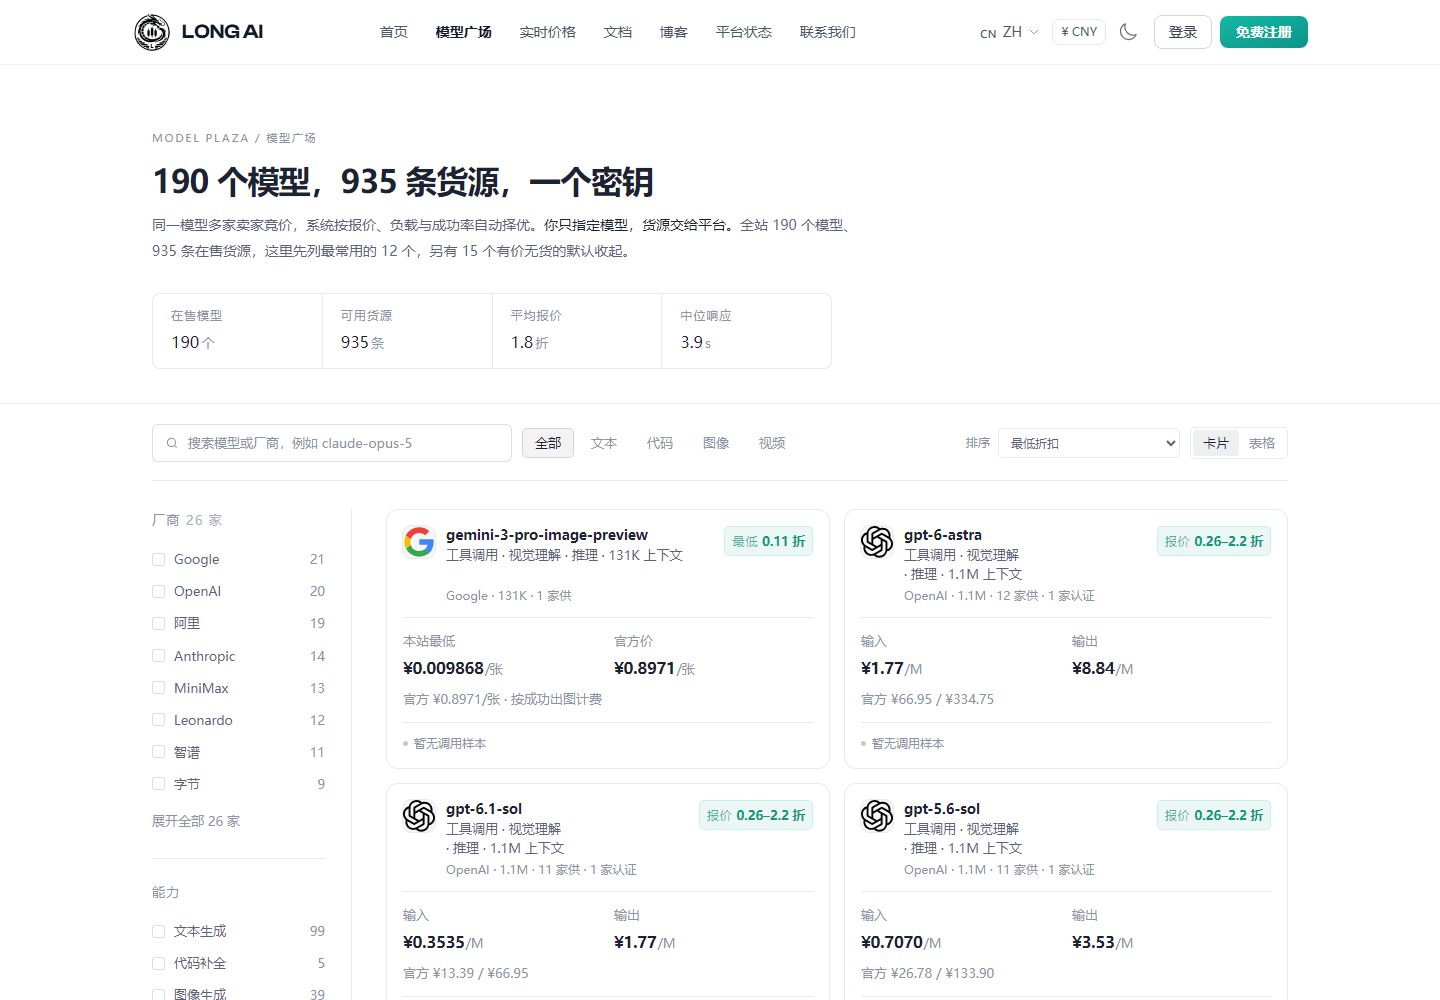
所以要认清一条:/v1/models 是名字清单,广场才是当前可买清单。这两者不是一回事。
实测证据:gpt-5.2 在 /v1/models 里能查到,广场里搜不到,直接调用:
HTTP/1.1 404 Not Found

{"error": {"code": "model_not_found",
           "message": "Model \"gpt-5.2\" is not available",
           "type": "invalid_request_error"}}
脚本里「先查清单、有就跑」这种写法不可靠。能跑什么,以广场搜索为准。
二、同一个模型,站内能找出 5 种写法
顺着清单往下翻,DeepSeek 那一个模型出现了好几种写法。挑 5 个分别打了一次,全部 200:
deepseek-v4.1-flash→ 输入 35 tokenali/deepseek-v4.1-flash→ 输入 44 tokencb/deepseek-v4.1-flash→ 输入 35 tokenalicn/deepseek-v4.1-flash→ 输入 44 tokenDeepSeek-V4.1-Flash(大写加连字符)→ 输入 51 token
同一句话,输入 token 从 35 到 51,差 46%。这不是模型变了,是背后挂的上游不是同一台:带前缀的写法直接锁定某一家货源,裸名由系统路由;大写那个是独立条目,连分词方式都不同。
对普通用户的实际影响:别自己去清单里挑带前缀的名字。前缀是给需要锁定特定货源的场景用的;日常照广场上显示的规范名写就够了,路由、比价、故障切换交给平台。
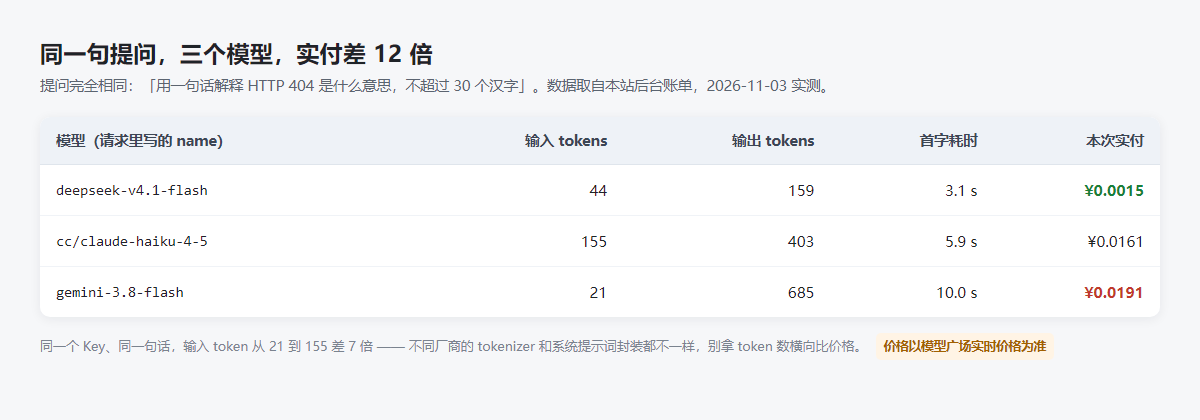
三、跨三个厂商:同一句话,实付差 12 倍
还是那个 Key,同一句「用一句话解释 HTTP 404 是什么意思,不超过 30 个汉字」,依次打三家:
三个反直觉的点:
- 输入 token 差 7 倍(21 / 44 / 155)。同样二十来个字,Claude 那条算了 155——它把系统提示和封装一起算进输入了。所以跨模型比「token 数」没意义,只能比钱。
- 官方成本贵的,实付不一定按同比例贵。Gemini 这条官方成本是 DeepSeek 的 25 倍,但本站各模型货源折扣档不同,最终实付只差 12 倍。
- 首字慢不等于输出少。DeepSeek 3.1 秒出首字,Gemini 要 10 秒;但 Gemini 一口气吐了 685 token,实际单位时间的产出反而更高。
结论很直接:同一个 Key 里,模型之间的价差是两位数倍,切换前先看广场报价,别凭印象。各家的官方价与本站实付价,可以参考我们做过的四家模型价格对比表;具体单价以模型广场实时价格为准。
四、切换的正确姿势:只改一个字段
接口是 OpenAI 兼容的,做多模型切换不用换 SDK、不用换 Key,只改 model 一个字段:
import requests

KEY = "sk-你的Key"
URL = "https://ai.dijinlong.com/v1/chat/completions"

def ask(model, question):
    r = requests.post(URL, timeout=120,
        headers={"Authorization": f"Bearer {KEY}"},
        json={"model": model,
              "messages": [{"role": "user", "content": question}],
              "max_tokens": 800})
    r.raise_for_status()
    d = r.json()
    return d["choices"][0]["message"]["content"], d["usage"]

for m in ["deepseek-v4.1-flash",
          "claude-haiku-4-5",
          "gemini-3.8-flash"]:
    text, usage = ask(m, "用一句话解释 HTTP 404")
    print(m, usage["prompt_tokens"],
          usage["completion_tokens"])
三条规则:
- 模型名从广场复制,别手打。大小写、连字符、版本号尾巴,错一个就是 404。
- 给每次调用加
timeout。三家实测首字耗时 3 到 10 秒,慢模型不设超时会把程序挂死。 - 把返回的
usage记进日志。同一句话三家输入 token 能差 7 倍,不记账你永远不知道自己贵在哪。多轮对话里历史会被重复计费,逐轮账单可以看这篇 token 计费实测。
五、常见报错与常见问题
- 404 model_not_found,但名字明明在清单里
原因:这个模型已下架,或当前不在可售范围。
解决:去广场搜一次,搜得到才用;搜不到就换同档替代型号。 - 404 model_not_found,而且所有模型都这样
原因:这个 Key 被设了可用模型白名单(model_scope),白名单外的模型一律按「不存在」处理。我用一个只放行 OpenAI 系的 Key 去调 DeepSeek,返回的就是上面那句一模一样的 404。
解决:换一个没限制的 Key,或让发 Key 的人放开范围。这个报错和「名字写错」的文案一字不差,光看报错分不出来,只能拿一个已知能用的模型反测。 - 502 或 503 temporarily unavailable
原因:名字对了,但这个模型当前没有可用货源。实测gpt-5.4连打三次全是 503,同时段gpt-6-sol正常返回 200。
解决:等几分钟重试,或直接换型号——这种情况改名字没用,是货源问题。 - 401 invalid_api_key
原因:Key 停用、已删除,或者复制时带了空格换行。
解决:重新复制一次;还不行就是 Key 已失效,去后台新建。 - 429 请求过于频繁
原因:短时间并发太高,或这个 Key 有速率上限。
解决:加退避重试(1 秒、2 秒、4 秒),并发先降到 3 以下。 - 返回 200,但 content 是空的
原因:max_tokens给太小,额度被推理过程吃光了。
解决:把max_tokens提到 800 以上,这类模型宁可多留余量。
六、五分钟自检清单
- ① 广场搜模型名,搜得到再用,别信 /v1/models。
- ② 用同一个 Key 连打两个不同厂商的模型,都通才说明 Key 没有白名单限制。
- ③ 把每次的 usage 和实付写进日志,一周后你就知道哪个模型在烧钱。
要开始跑,注册后建一个 Key 就能覆盖全部模型,不用为每家厂商单独注册。