API 的 token 怎么算钱?5 轮对话实测账单
先说结论,省得你翻到最后:API 不按"调用次数"收钱,按 token 收。同一个模型,输出比输入贵 4 倍;多轮对话里,前几轮的问答每次都要重新发一遍、重新计费。把这两条搞明白,账单就不会莫名其妙。
下面是真实跑出来的账,不是估算。
一、先看清账单依据:返回体里的 usage
接口是标准 OpenAI 兼容格式,一次最简单的调用长这样:
curl https://ai.dijinlong.com/v1/chat/completions \
  -H "Authorization: Bearer 你的Key" \
  -H "Content-Type: application/json" \
  -d '{"model":"deepseek-v4.1-flash",
       "messages":[{"role":"user","content":"只回复两个字:收到"}],
       "max_tokens":20}'
返回体里这一段就是计费依据:
"usage": {"prompt_tokens": 35, "completion_tokens": 16, "total_tokens": 51}prompt_tokens 是你发过去的(输入),completion_tokens 是模型回的(输出)。两个数各乘自己的单价,加起来就是这次调用的钱。
二、中文真的比英文贵吗?实测几乎一样
拿三句意思相近、形式不同的内容各调一次,只看 prompt_tokens:
- 中文 39 字 → 52 token(约 1.33 token / 字)
- 同义英文 116 字符 → 53 token(约 0.46 token / 字符)
- 一行 JSON 请求体 90 字符 → 60 token(约 0.67 token / 字符)
结论有点反直觉:中文每个字确实"贵",但字少,整句话的账跟英文基本打平(52 对 53)。为了省 token 把中文硬翻成英文,纯属白忙,还多一层翻译误差。
真正该小心的是中文长文:按 1.33 token / 字算,一篇一万字的文档塞进提示词,一次就是一万三千多个 token。
三、连续追问 5 轮,输入 token 从 83 涨到 284
我设了一段 75 字的系统提示词(模拟客服机器人),再连续问 5 个短问题,每轮都把完整历史发回去——这是绝大多数聊天客户端和 Agent 的默认做法。
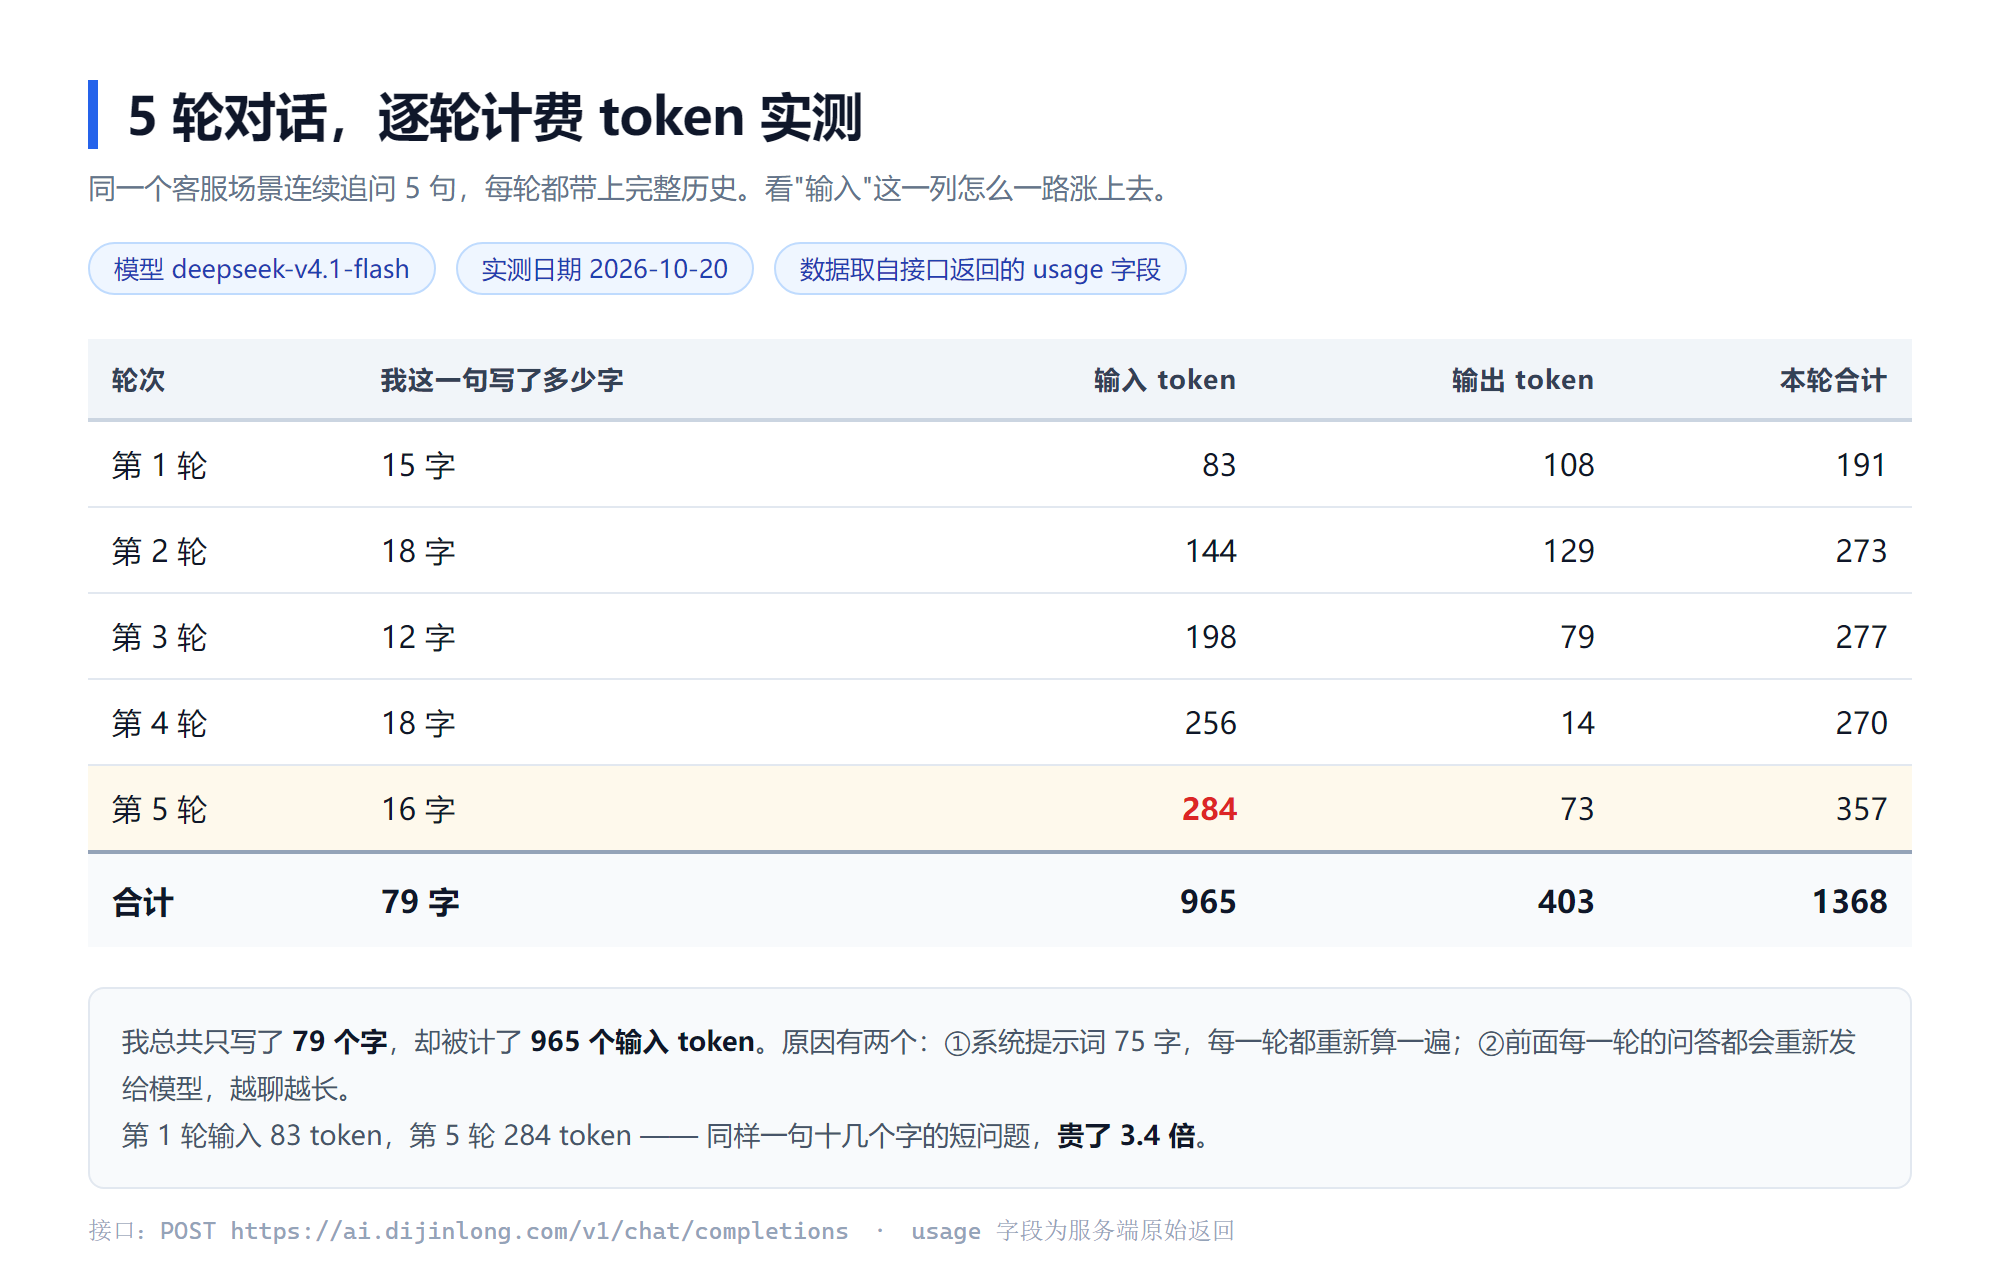
- 第 1 轮输入 83 token,第 5 轮 284 token,涨了 3.4 倍。而这五句话本身几乎一样长。
- 5 轮输入合计 965 token,可我五句话加起来只有 79 个字。
- 多出来的部分从哪来?系统提示词 75 字(约 44 token)每轮重算一次,剩下的全是前几轮问答被反复重发。
- 44 这个数怎么来的:同一句话不带系统提示词单独问,输入 39 token;带上系统提示词是 83 token,差 44。
四、钱到底花在哪:输出占了六成
按模型广场里 deepseek-v4.1-flash 的实付价(入 0.20 元 / 出 0.80 元,每百万 token)算这 5 轮:
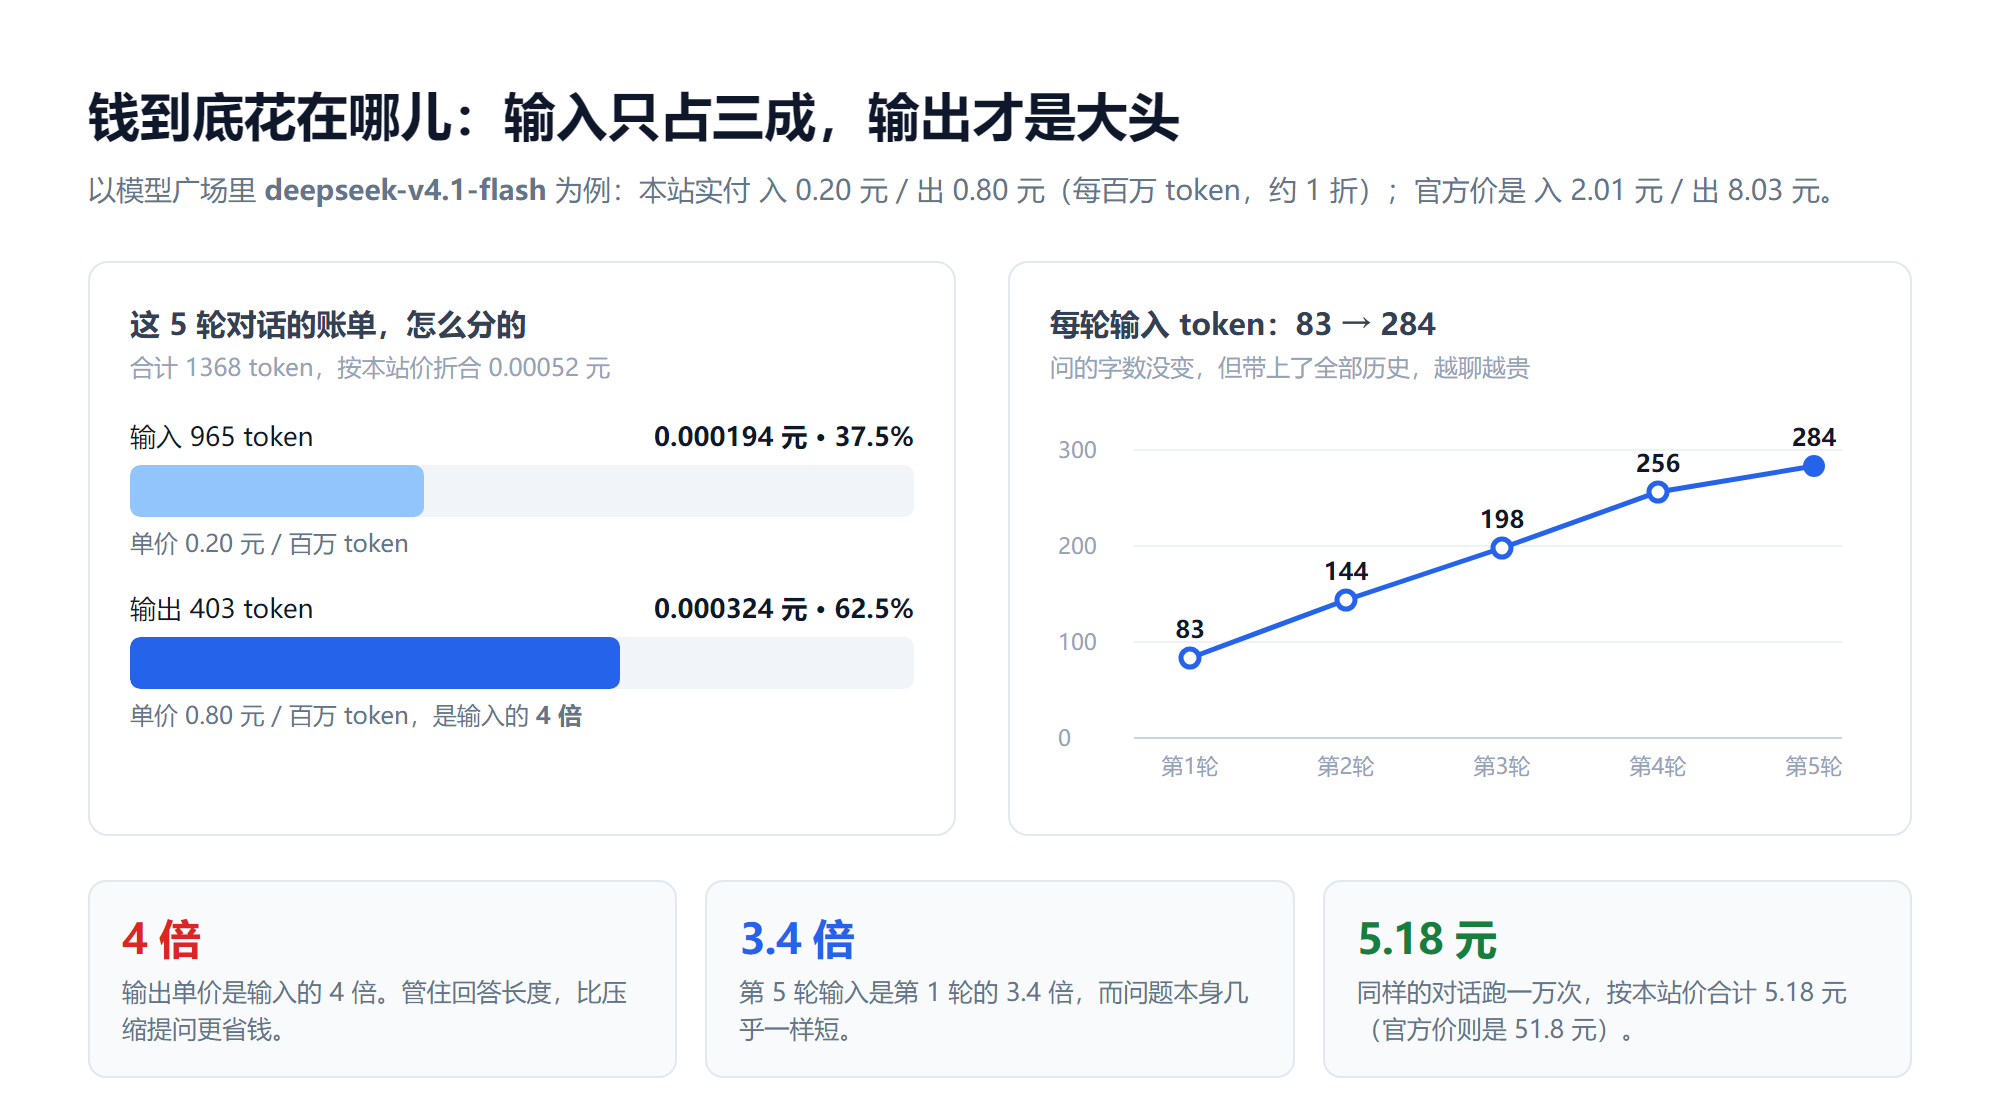
- 输入 965 token = 0.000194 元,占 37.5%
- 输出 403 token = 0.000324 元,占 62.5%
- 合计 0.00052 元。同样的对话跑一万次,5.18 元。
这个比例的直接结论是:想省钱,先管输出。把提问压缩一半,最多省 18% 的钱;把回答从 200 字压到 50 字,省的是大头。
价格会调整,实际单价以 模型广场 实时价格为准。
五、三个马上能改的动作
- 只带最近 2 轮历史。实测对照:同样 5 个问题,不带历史单独问,输入合计 198 token,比带全部历史的 965 token 少 4.9 倍。把旧对话做摘要、只留最近几轮,是最直接的省法。
- 在系统提示词里写死"回答不超过多少字"。输出单价是输入的 4 倍,这是唯一能直接砍掉六成花费的开关。
- 别把整篇文档原样塞进提示词。先检索、再摘要,只把相关段落发过去。中文一万字一次就是一万三千 token。
还有一个实测踩到的坑:把这个模型的 max_tokens 设成 8、要求它只回两个字,返回的 completion_tokens 仍然是 128,且全部记在 reasoning_tokens 里。推理模型的"思考过程"也按输出计费,小 max_tokens 卡不住它。想压花费,得从缩短任务、换非推理型号入手,别指望这个参数。
六、常见报错:原文、原因、怎么解决
下面这些是实际调用里抓到的原始返回,不是从文档抄的。
- 401
{"code":"INVALID_API_KEY","message":"Invalid API key"}
原因:Key 复制不全、带了空格,或这把 Key 已停用。
解决:重新复制;Bearer后只跟一个空格,别写成两个 Bearer。 - 400
{"error":{"message":"The request parameter input is invalid or missing. Please check the value of this parameter."}}
原因:请求体缺字段,最常见是 messages 没传或不是数组。
解决:检查每条消息都有 role 和 content,role 只能是 system / user / assistant。 - 400
{"error":{"message":"Model is not supported by composite groups"}}
原因:模型名不在当前 Key 所属分组的可路由范围内,名字错一个字母就长这样。
解决:到模型广场复制完整模型名;带斜杠的全名和短名不是一回事。 - 404
{"error":{"code":"model_not_found","message":"Model \"xxx\" is not available"}}
原因:模型不存在,或这把 Key 没开这个模型。
解决:先核对拼写,再确认 Key 的可用模型范围。 - 429
{"error":{"message":"All upstream providers for this model are rate-limited. Please retry later."}}
原因:这个型号的所有上游同时在限流,不是你一个人被限。
解决:等几十秒重试;着急就换同系列另一个型号。 - 502
{"error":{"message":"Upstream service temporarily unavailable"}}
原因:上游临时不可用。
解决:重试一两次;连续三次都这样,换模型。
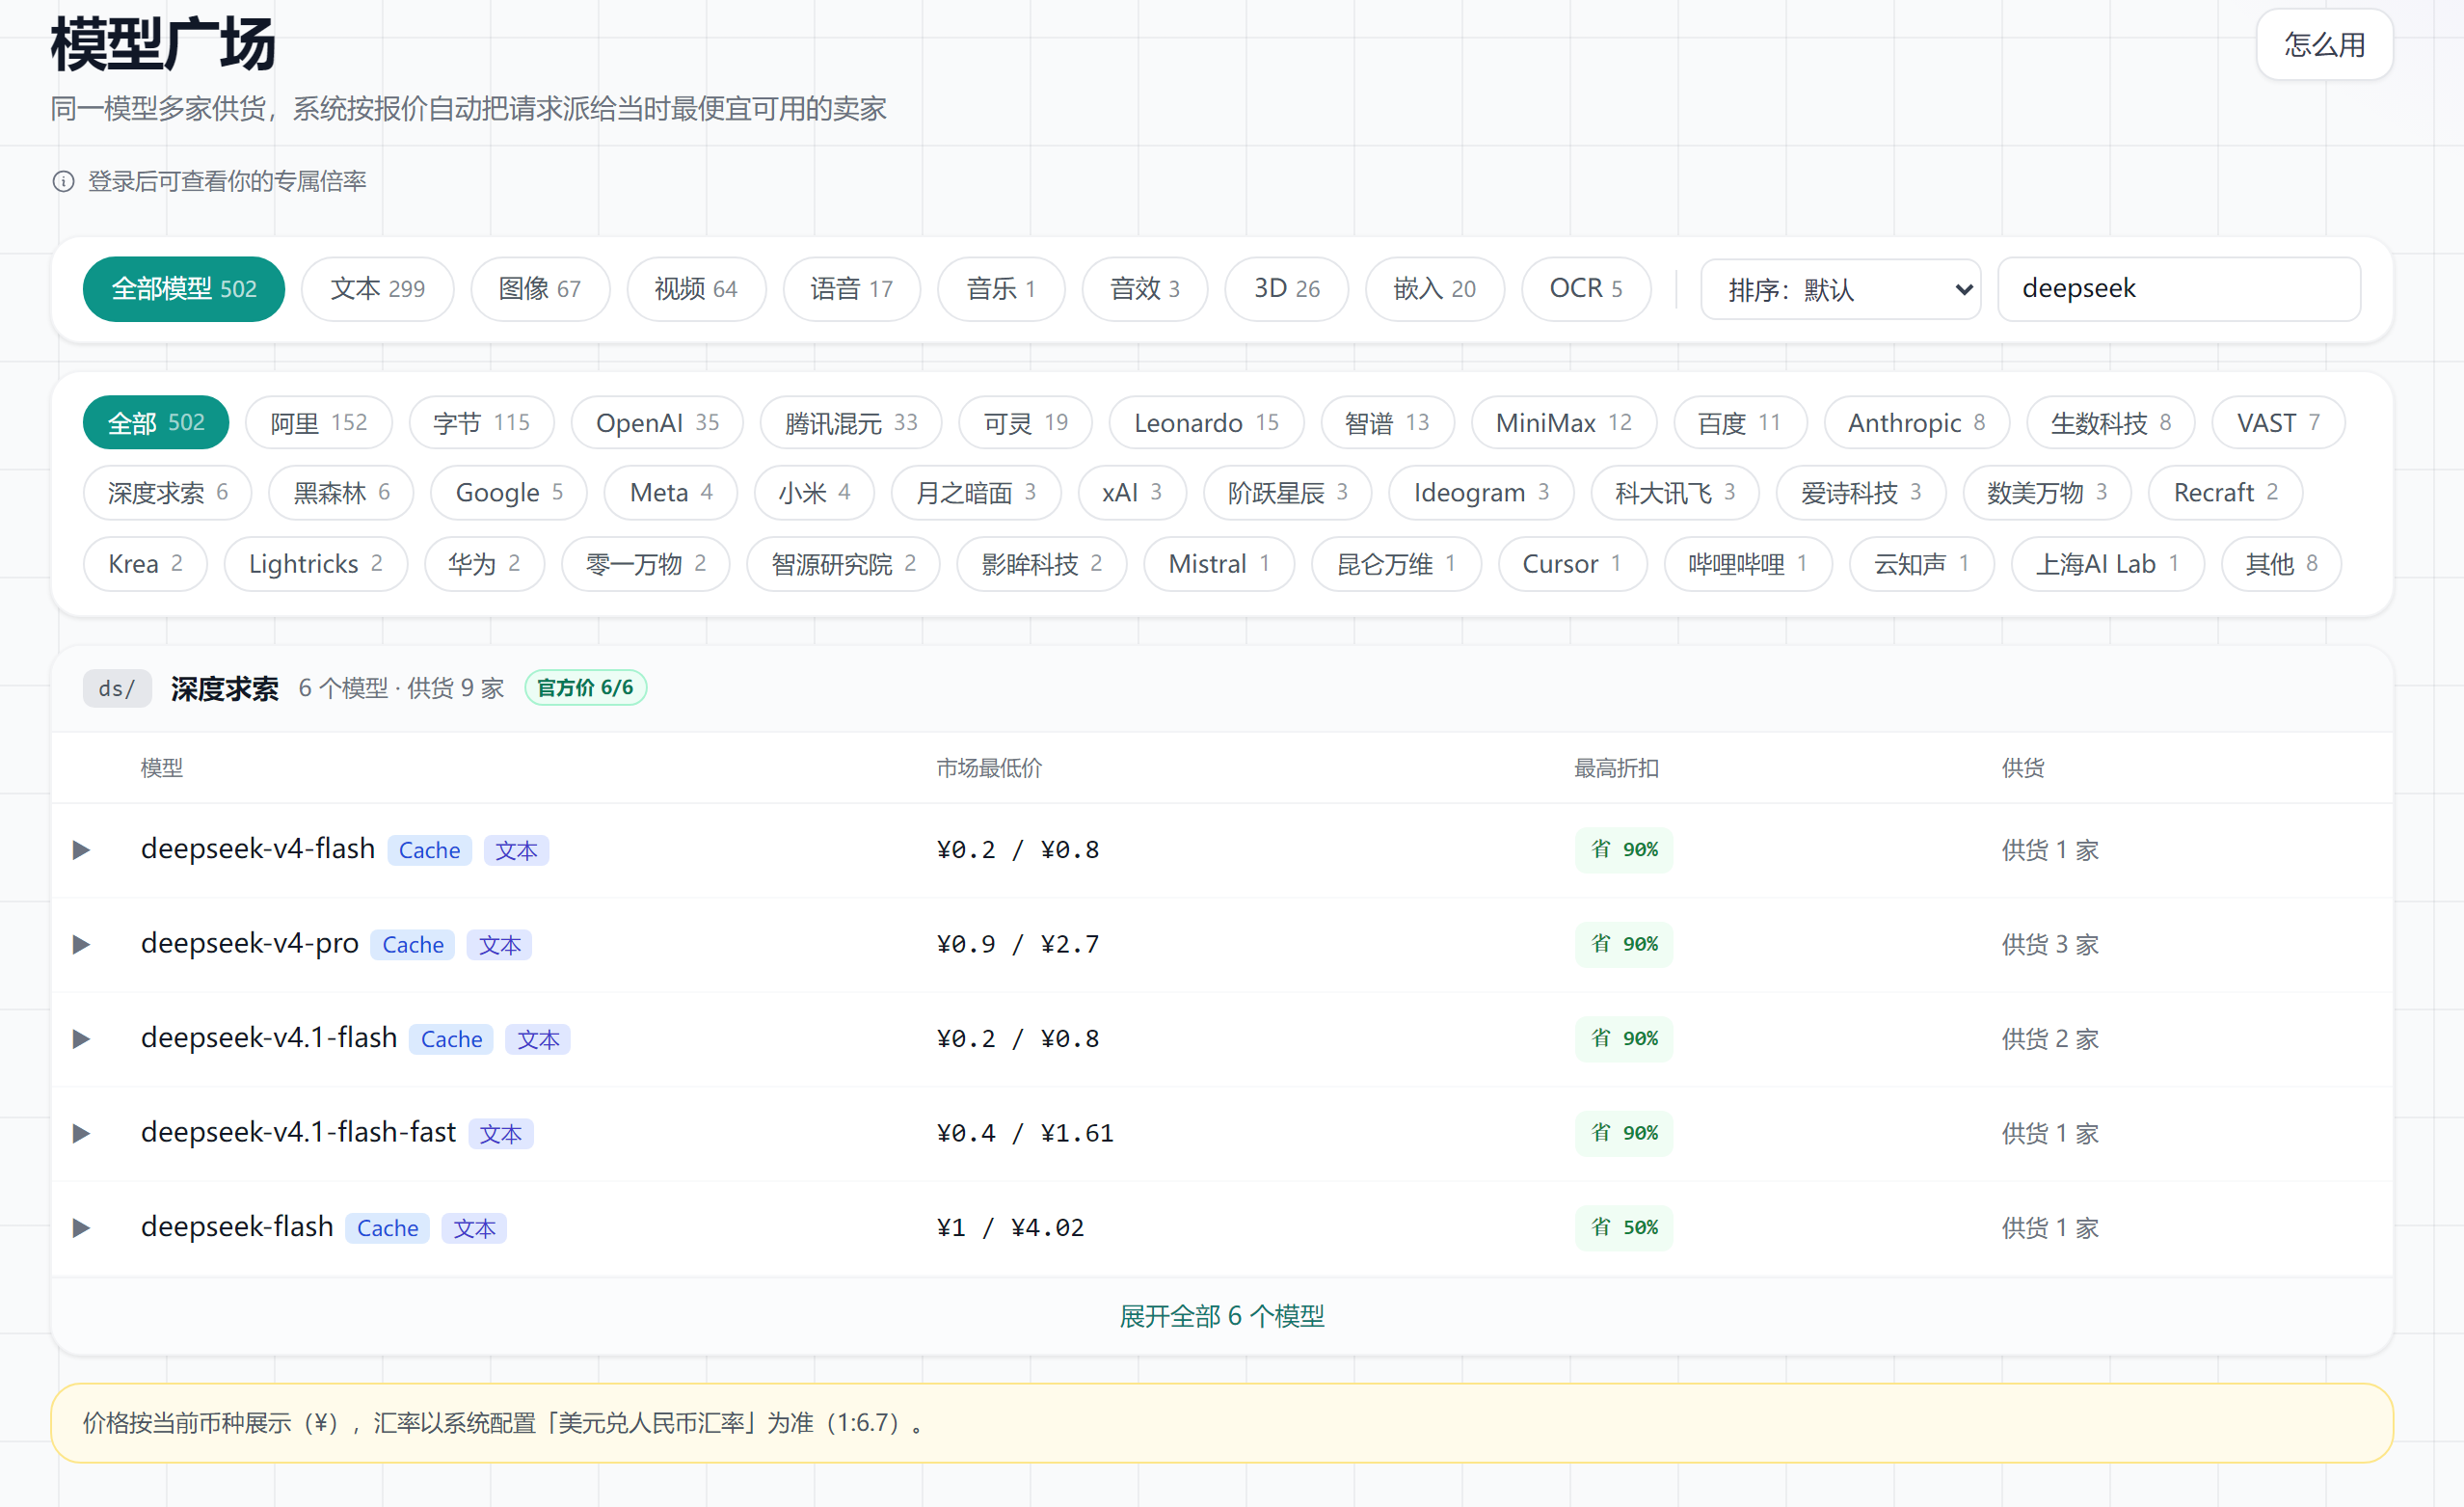
顺带一提,模型广场里能看到每个型号的供货家数和折扣,比如截图这一屏,DeepSeek 系列 6 个型号、官方价覆盖 6/6:
七、给你一个能自己算的公式
单次成本 = 输入 token 合计 × 输入单价 + 输出 token 合计 × 输出单价。注意输入合计不是"你打的字",而是"每轮发出去的全部内容之和"。
想验证,就把每次返回的 usage 存进日志,跑一天再看合计。要把自己的程序接进来,改 base_url 就行,LONG AI 的接口与 OpenAI 完全兼容。