11 月 11 日上午 10 点,阿里云百炼的「模型上架与更新」页多了一行:qwen4-max-preview。这是 Qwen4 这一代第一次在官方文档里有了正式页面——此前 10 月 31 日的从业者预热、11 月 4 日的仓库与型号泄露,都只是传闻。
但同一条公告里还压着两句容易被跳过的限定:仅支持 Token Plan,不支持按量计费;预览期为 11 月 11 日 10:00 至 11 月 25 日 24:00,预览结束后下线。也就是说,这是一个十四天后就关门的试用窗口,不是可以接进生产的新模型。
reasoning_effort 在 low / medium / xhigh 之间调,默认 xhigh;不能与 thinking_budget 同时设。token-plan.cn-beijing.maas.aliyuncs.com。按量计费的普通百炼 Key 调不动它。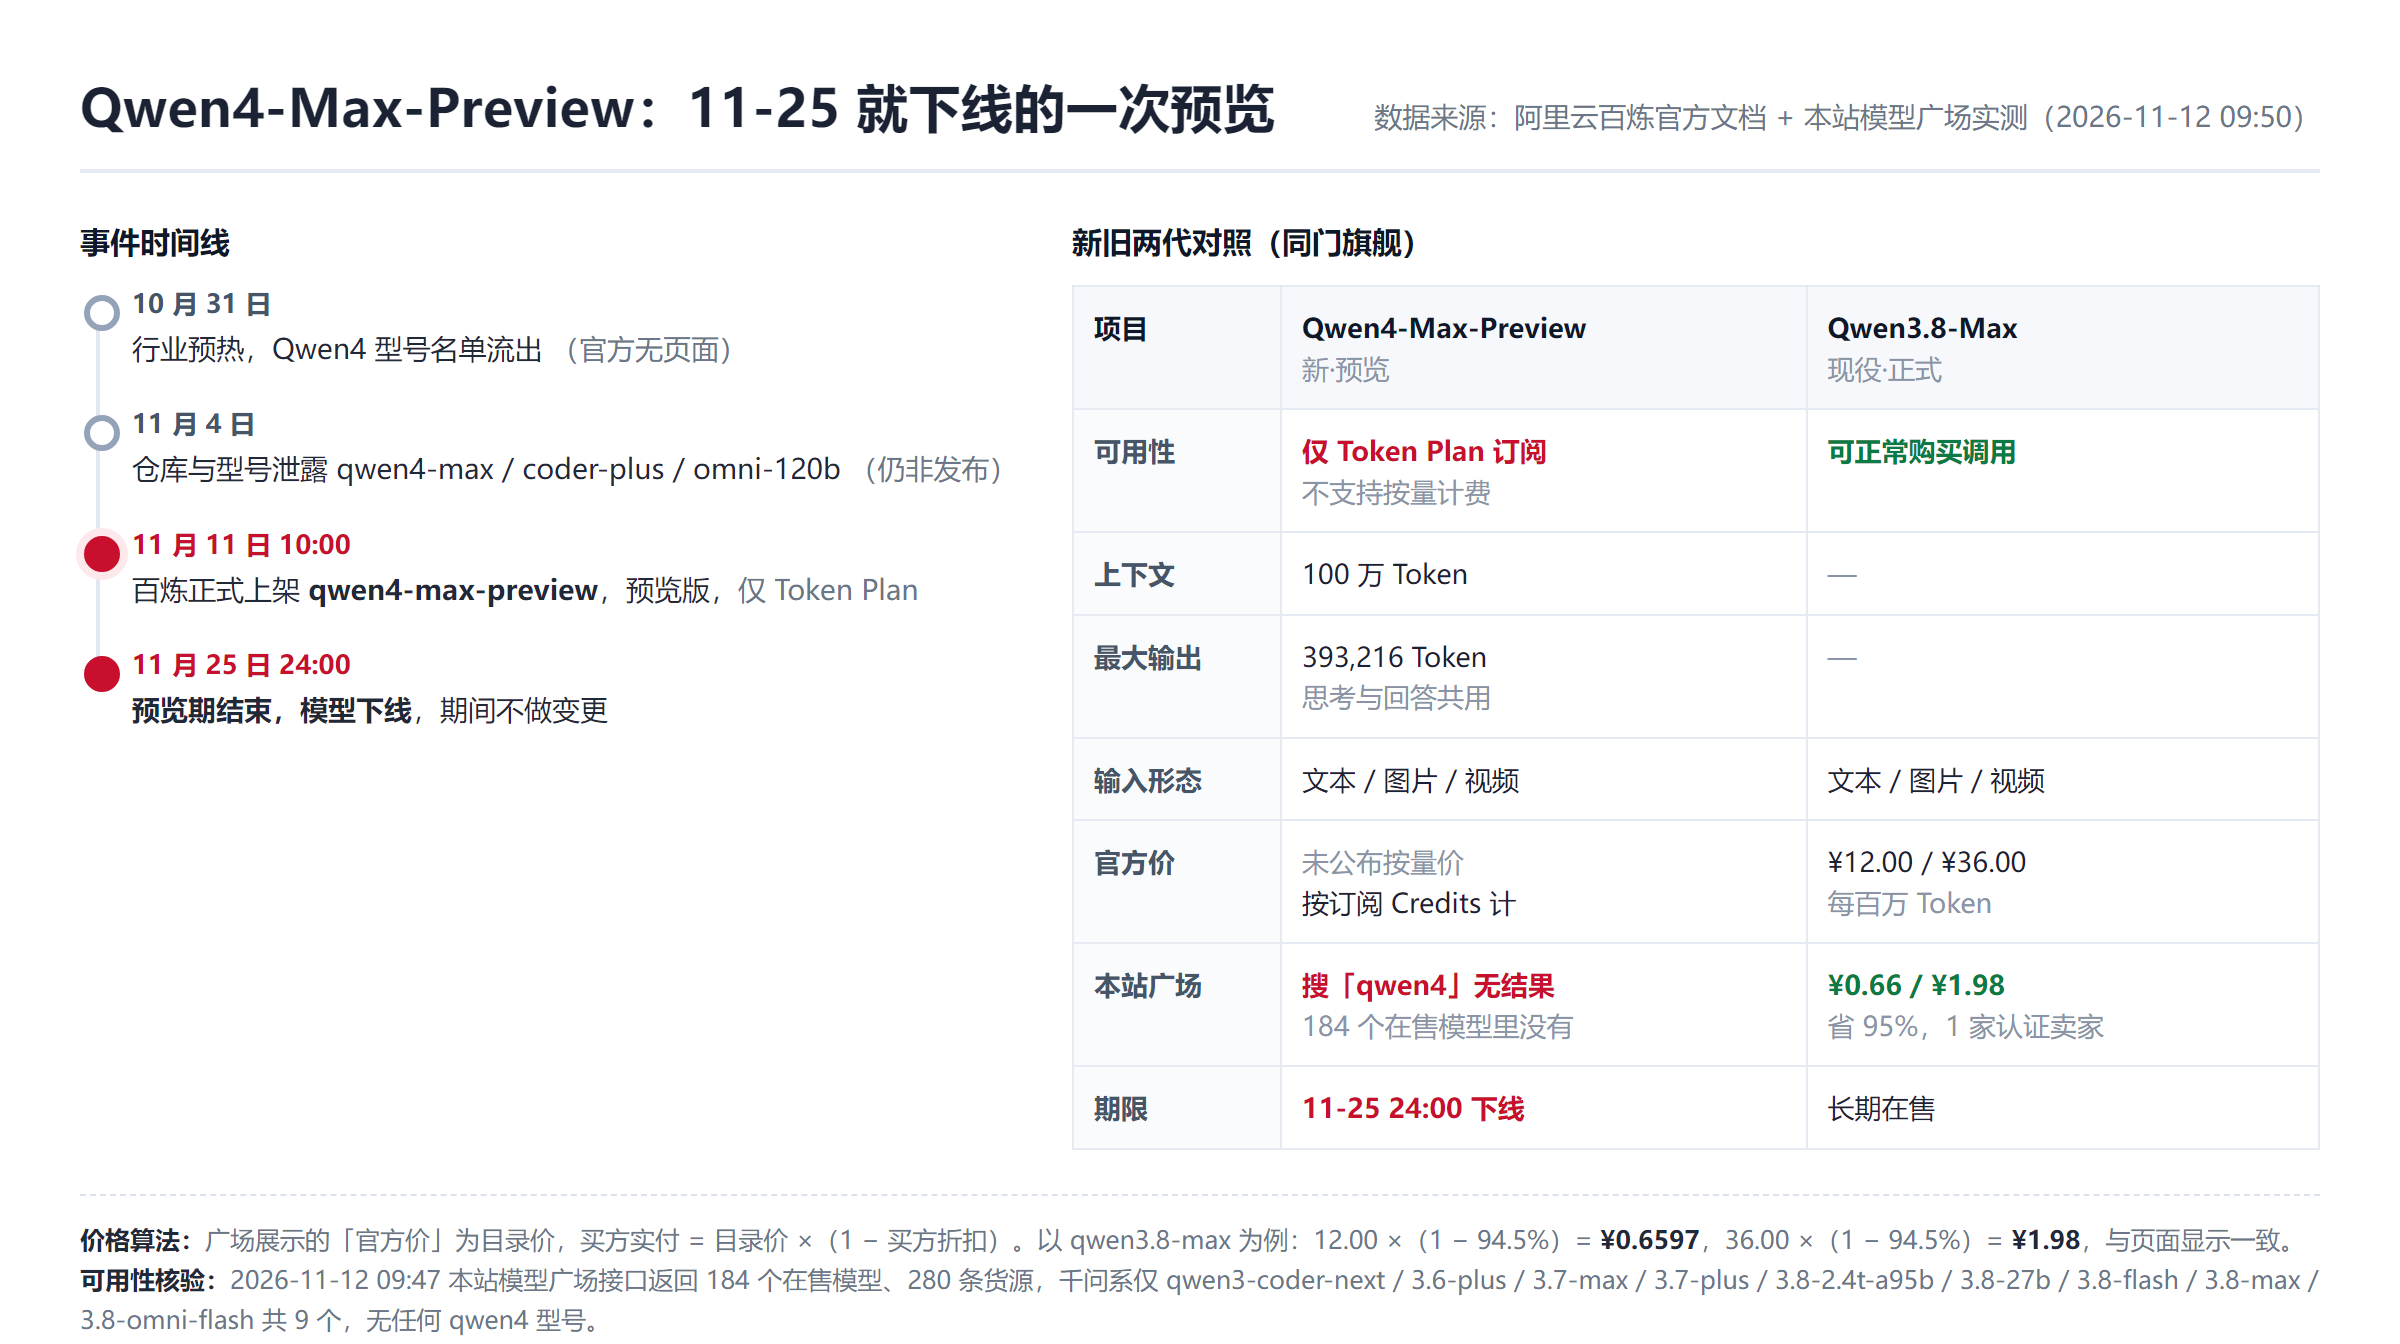
第一,还能不能用。能用,但门槛换了地方。你手上那张按量计费的百炼 Key 对它无效,必须先订阅 Token Plan(个人版或团队版,包月、包季、包年均可),再在控制台生成套餐专用 Key。(订阅合同与按量计费不同,退订规则先看清。)
第二,价格没法按 Token 算。官方没有给这个型号任何按量单价,Token Plan 用 Credits 统一计量。换言之,你算不出「每百万 Token 多少钱」,只能算「一个套餐能做多少次活」。这和 qwen-max 那套「输入多少钱、输出多少钱」的直觉完全不同——想比价的人,这里会比不出来。
第三,要不要换。不建议换到生产。11 月 25 日 24:00 预览结束即下线,把模型名写进代码,两周后必然报错,而且官方写明「期间不做变更」,等于连补丁窗口都没有。
还有一个会咬人的细节:从 qwen4-max-preview 起,max_tokens 与 max_completion_tokens 变成等价参数,两者都限制「思考 + 回答」的总量。旧代码如果只按回答长度预留上限,开了思考就会提前截断。官方文档把这条单独拎出来写,说明已有用户踩到。
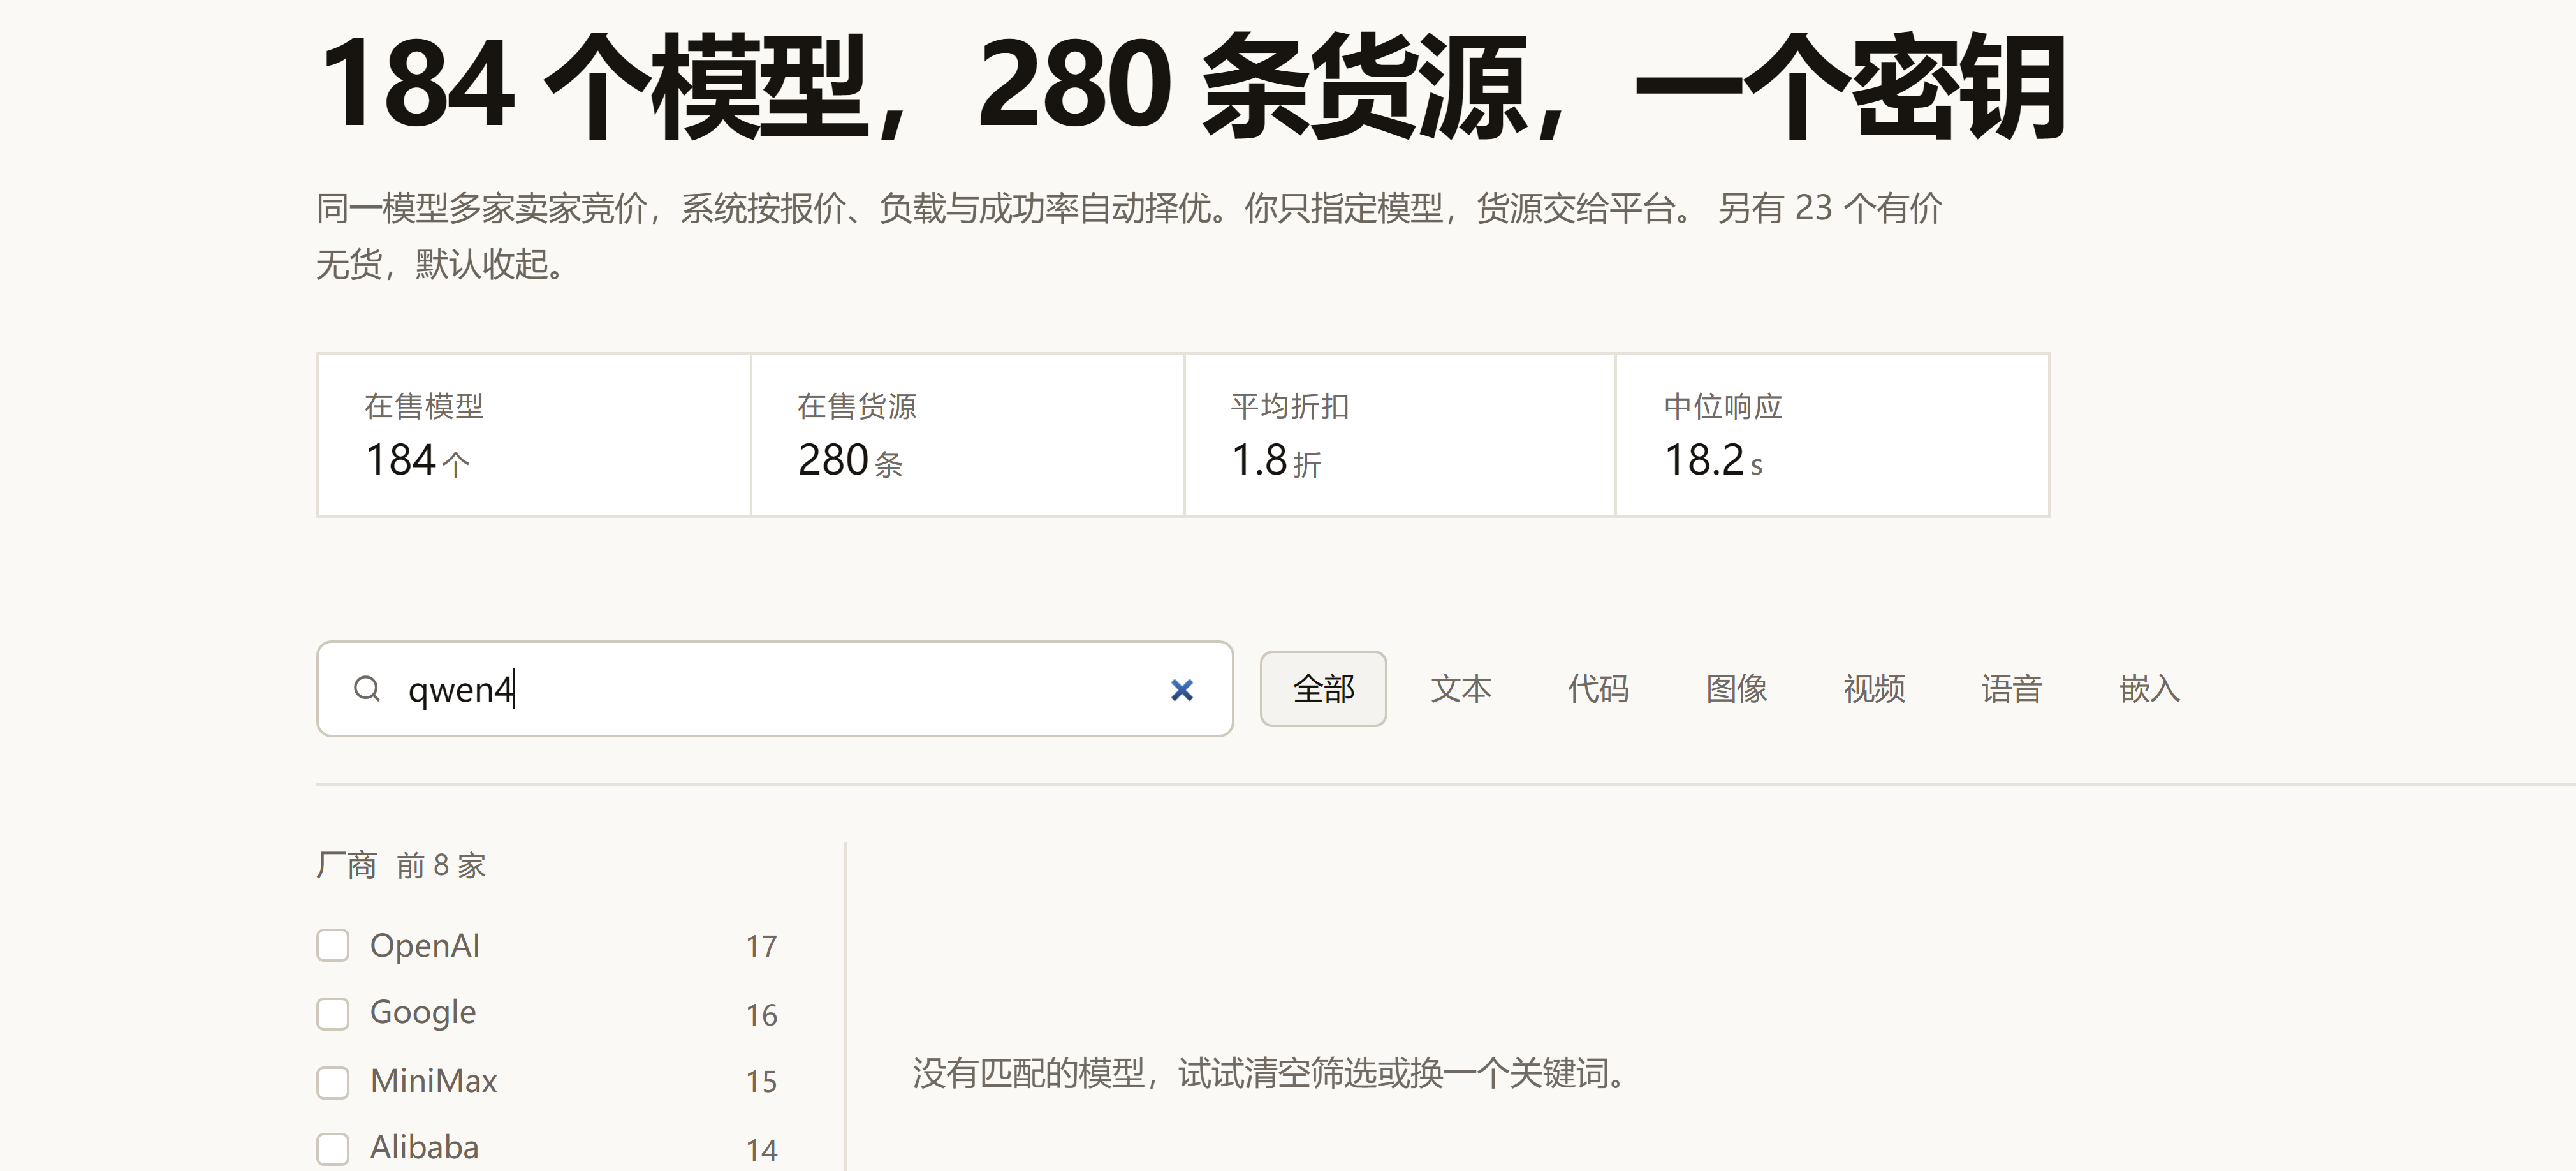
2026 年 11 月 12 日 09:47,我们拉了本站模型广场接口:184 个在售模型、280 条货源。千问系在售 9 个——qwen3-coder-next、qwen3.6-plus、qwen3.7-max、qwen3.7-plus、qwen3.8-2.4t-a95b、qwen3.8-27b、qwen3.8-flash、qwen3.8-max、qwen3.8-omni-flash——没有任何 qwen4 型号。在广场搜索框输入「qwen4」,列表区返回「没有匹配的模型」。
对照价格用同门现役旗舰 qwen3.8-max 更实际。它今天在广场有 1 家认证卖家挂单、标省 95%,页面显示输入 ¥0.6597/M、输出 ¥1.98/M,官方目录价 ¥12.00 / ¥36.00。算法是:12.00 ×(1 − 94.5%)= 0.6597,36.00 ×(1 − 94.5%)= 1.98。这是买方实付,与页面数字对得上。
preserve_thinking 默认开启,多轮对话必须把历史 assistant 消息里的 reasoning_content 完整回传,不能拼进 content;以及上面说的 max_tokens 预算合并。官方信息来自上述三个阿里云帮助中心页面(模型页 2026-11-11 20:44 更新),规格、日期、限制均为原文照录。本站可用性来自 /api/v1/model-plaza 接口与广场页面实测(2026-11-12 09:47),口径为页面口径。人民币价格为广场实付价,算法已在正文写明。本文没有实测 Qwen4-Max-Preview 的速度与效果——买不到按量额度、也不是我们的在售货源,就不做「谁更强」的判断,也不转述厂商自评分数。配图为本站截图与自制对照图。想弄清计价方式的,可先看 token 怎么算钱。
OpenAI发布GPT-6.2并把旗舰价下调20%,阿里、腾讯同周把单任务成本和缓存价压到新低。结论:官方降价仍远高于本站实付价,gpt-6-astra现在最深0.099折,实付$0.099/百万输入token。日常用现款便宜档,追新等上架比价。
大模型缓存token是什么?一句话:把重复的提示词前缀存下来,命中后按缓存读计价,通常只有正常输入价的5%到12%。本文用在售模型的真实缓存价,讲清缓存读写怎么算钱、什么情况命中,以及怎么把账单压下来。
Claude 有哪些模型?站内 12 个版本按实付价排完发现:最新的 opus-5-5 月成本 $8.91,最老的 opus-4-6 反而 $49.50。本文给出全系价格表、真实实测数据与四个场景的选型结论,日常开发选 sonnet-5-5 最稳。
写代码用哪个 AI 模型?按本站实付价和 24 小时实测:gpt-5.6-terra、deepseek-v4.1-flash 各三千多次调用零失败,每月千次请求分别 $2.85 和 $1.66;gemini-3.8-flash 出字 111 token/s 最快。附完整实付价表与三档选型建议。
拿到密钥后把 API 地址改成平台地址,就能用一个 Key 调用在售的 138 个模型(覆盖 51 家厂商),同时兼容 OpenAI 和 Anthropic 两种请求格式。本文给出可直接复制的接入代码、模型切换方法和常见坑,全部接口已实测验证,数据截至 11 月 16 日。
 LONG AI