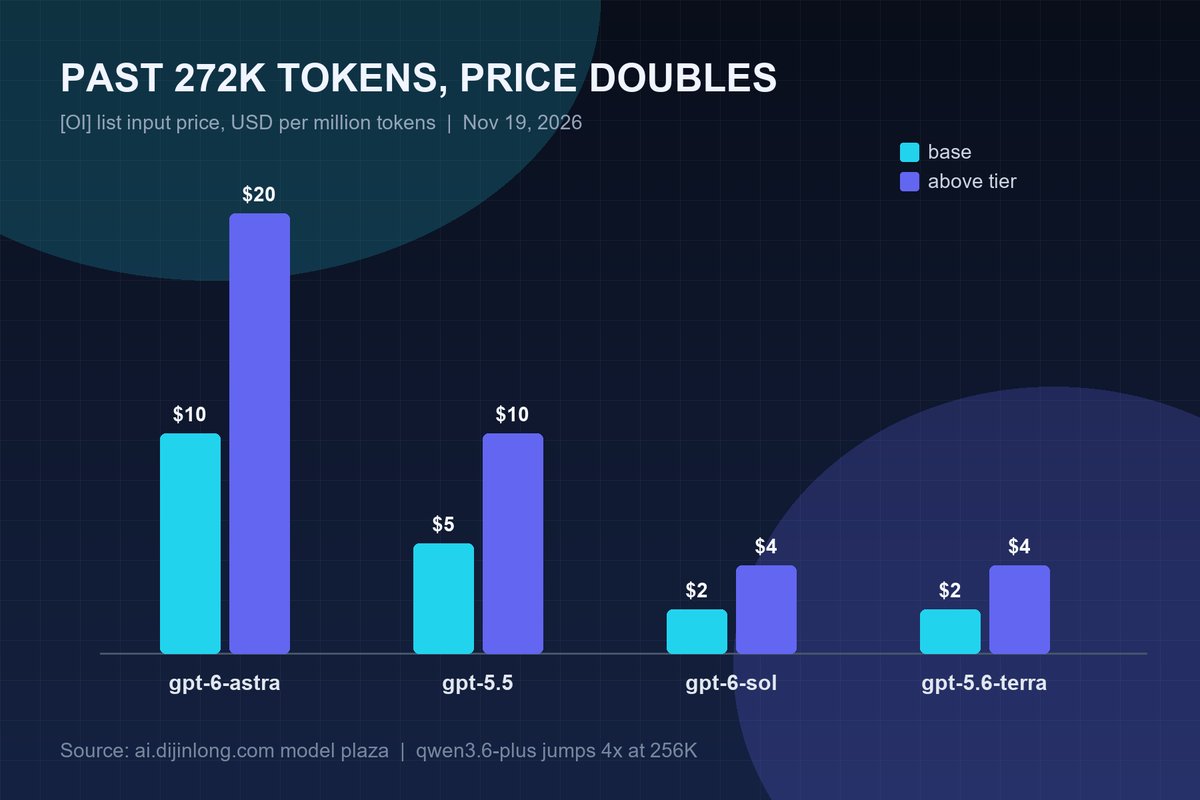
上下文窗口能装一百万字,不等于按一百万字的价格收费。本站 53 个在售文本模型里,37 个标称 100 万 token 以上上下文,但其中带「按输入长度分档」的模型,一旦越过阈值输入价立刻上调:gpt-6-astra 过 27.2 万 token 从 $10 跳到 $20,qwen3.6-plus 过 25.6 万从 2 元跳到 8 元,直接 4 倍。处理长文档时,选错模型的代价往往比选错价格档更大。数据截至 11 月 19 日。
下面这张表逐个列出广场价表里带档位的模型,基础档和越档后的官方价都照抄,不做取整。
| 模型 | 上下文 | 基础档(输入 / 输出) | 越档触发点 | 越档后(输入 / 输出) | 倍数 |
|---|---|---|---|---|---|
| gpt-6-astra | 105 万 | $10 / $50 | > 27.2 万 | $20 / $75 | 输入 2 倍 · 输出 1.5 倍 |
| gpt-5.5 | 105 万 | $5 / $30 | > 27.2 万 | $10 / $45 | 输入 2 倍 · 输出 1.5 倍 |
| qwen3.6-plus | 100 万 | 2 元 / 12 元 | > 25.6 万 | 8 元 / 48 元 | 输入输出各 4 倍 |
| glm-4.7 | 20.5 万 | 2 元 / 8 元 | 输入 3.2 万–20 万 | 4 元 / 16 元 | 输入输出各 2 倍 |
| glm-5 | 20.5 万 | 4 元 / 18 元 | ≥ 3.2 万 | 6 元 / 22 元 | 输入 1.5 倍 · 输出 1.22 倍 |
| glm-5.1 | 20.5 万 | 6 元 / 24 元 | ≥ 3.2 万 | 8 元 / 28 元 | 输入 1.33 倍 · 输出 1.17 倍 |
| glm-5-turbo | 20.3 万 | 5 元 / 22 元 | ≥ 3.2 万 | 7 元 / 26 元 | 输入 1.4 倍 · 输出 1.18 倍 |
三个观察。第一,[OI] 全系按 27.2 万 token 划线,倍数统一:输入 2 倍、输出 1.5 倍。第二,智谱 glm 系列按 3.2 万划线,倍数小(输入 1.5 倍上下)但触发早,日常稍长的对话就会踩线。第三,qwen3.6-plus 是唯一的 4 倍跳,而且输入输出一起跳。
另外两个模型在价表里没有单列档位,官方说明写得很清楚:gpt-6-sol、gpt-5.6-terra 在输入超过 27.2 万 token 时,同样按输入 2 倍、输出 1.5 倍计费。
[OI] 系列输入翻倍、输出只涨 50%,原因是长上下文多出来的成本集中在 prefill 阶段——把整段输入编码进缓存,解码阶段并没有同比变慢。对买家来说,这意味着「长输入 + 短输出」的任务受罚最重:把 30 万 token 丢进去只要 500 字摘要,是最不划算的用法。
glm 系列的 3.2 万档更像温和的分段计价,但对短输出任务同样不友好。输入从 4 元变 6 元看着只多一半,可输出同时从 18 元被推到 22 元,两头一起涨。
还有一个容易被忽略的细节:档位按单次请求的输入长度判定,不看累计调用。把 30 万 token 拆成十次 3 万 token 的请求,可以绕开 [OI] 的 27.2 万档;但换成 glm 系列就反过来了,3.2 万这条线会被每一段踩中,拆分反而更贵。
同一份 30 万 token 的技术手册,只做一次「整篇输入 + 2000 token 输出」,按官方价算单次成本:
| 模型 | 计算式 | 单次成本(官方价) |
|---|---|---|
| gpt-6-astra | 0.3 × $20 + 0.002 × $75 | $6.15 |
| gpt-5.5 | 0.3 × $10 + 0.002 × $45 | $3.09 |
| gpt-6-sol | 0.3 × $4 + 0.002 × $15 | $1.23 |
| qwen3.6-plus | 0.3 × 8 元 + 0.002 × 48 元 | 2.50 元 |
| glm-4.7 | 0.3 × 4 元 + 0.002 × 16 元 | 1.23 元 |
| glm-5.3-flash | 0.3 × 0.8 元 + 0.002 × 2.8 元 | 0.246 元 |
最贵的 gpt-6-astra 单次要 $6.15,最便宜的 glm-5.3-flash 只要 0.246 元(约 0.037 美元),差 160 多倍。更值得记住的是中间那两位:glm-4.7 是 20 万上下文中端模型,32K 就翻倍,这份文档要 1.23 元;glm-5.3-flash 是单档 104 万上下文的轻量模型,同一份文档 0.246 元,便宜 5 倍。长文档场景下,「便宜的中端」往往是最贵的选择。
再把口径说清楚:档位用的是「单次请求的输入 token 数」,不是对话框里的累计长度。一次请求只发 5000 token,即使这个对话总共累计了 40 万 token,也不会触发 27.2 万档——真正决定账单的是每次请求自己带了多少上下文。
一、先量 token 再选模型。上线前拿真实文档跑一次,看返回的 usage 里 input_tokens 到底多少。很容易估低——30 万 token 已经是一本几百页手册的量级。
二、卡在阈值下再裁剪。27.2 万这条线,把输入控制在 26 万以内;3.2 万这条线,控制在 3 万以内。多留那几千 token 换来的是价格翻倍,不值。
三、用检索和分段摘要代替整篇塞入。先把文档切块,只把相关段落送进模型;需要全局结论时先分段摘要再汇总,两轮的成本通常低于一次全长请求。
四、把稳定的长前缀交给缓存。gpt-6-astra 缓存读价 $1 / 百万 token,是它 $10 输入价的十分之一;kimi-k3 缓存读 $0.3,缓存写入与输入同价 $2.9873。系统提示、手册全文这类每轮都重复的内容走缓存,比每次重发便宜一个数量级。
需要说清的一点:平台展示的是官方价与卖家折扣,买家实付 = 官方价 ×(1 − 折扣);阶梯部分具体怎么折算,以下单时账单页的实际扣费为准。
两个地方看:模型广场 的模型卡片列出官方价表,带档位的模型能看到「≥32K」「>272K」这类标签;模型文档 的价格说明是官方口径原文,倍数和缓存规则都写在里面。
核对顺序建议:先看上下文窗口够不够(不够直接淘汰),再看有没有档位、阈值在哪,最后比折扣稳不稳——只有 1 个卖家、没有认证的档位,折扣随时可能撤掉。
同样 10 美元,本站能买到 455 万到 6.67 亿输入 token。本文按真实折扣算出 10 个模型的购买力、单次请求成本和三种预算组合,并指出便宜模型推荐里最容易踩的三个坑。
OpenAI发布GPT-6.2并把旗舰价下调20%,阿里、腾讯同周把单任务成本和缓存价压到新低。结论:官方降价仍远高于本站实付价,gpt-6-astra现在最深0.099折,实付$0.099/百万输入token。日常用现款便宜档,追新等上架比价。
大模型缓存token是什么?一句话:把重复的提示词前缀存下来,命中后按缓存读计价,通常只有正常输入价的5%到12%。本文用在售模型的真实缓存价,讲清缓存读写怎么算钱、什么情况命中,以及怎么把账单压下来。
Claude 有哪些模型?站内 12 个版本按实付价排完发现:最新的 opus-5-5 月成本 $8.91,最老的 opus-4-6 反而 $49.50。本文给出全系价格表、真实实测数据与四个场景的选型结论,日常开发选 sonnet-5-5 最稳。
写代码用哪个 AI 模型?按本站实付价和 24 小时实测:gpt-5.6-terra、deepseek-v4.1-flash 各三千多次调用零失败,每月千次请求分别 $2.85 和 $1.66;gemini-3.8-flash 出字 111 token/s 最快。附完整实付价表与三档选型建议。
 LONG AI