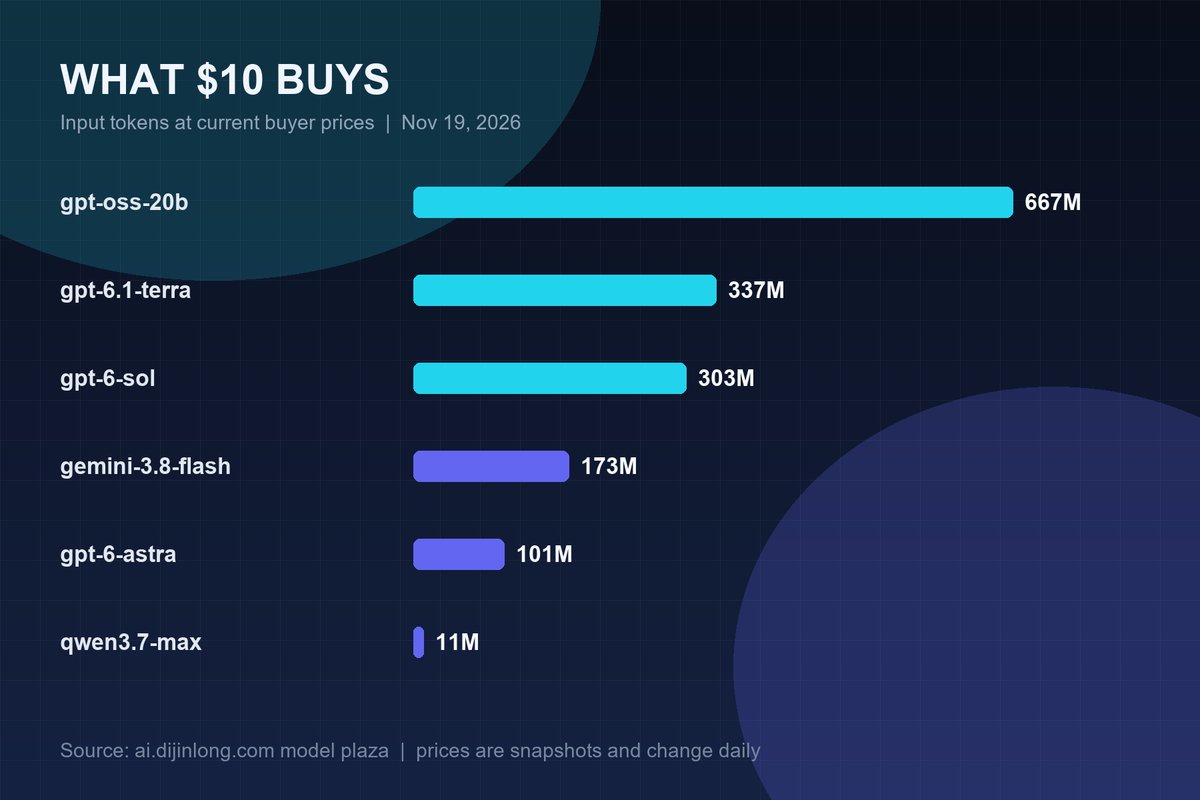
同样 10 美元,在本站能买到约 455 万到 6.67 亿输入 token,相差 147 倍——差距全在选型。想找便宜模型推荐,第一件事不是按官方标价排序:实付价排第二的 gpt-6.1-terra,官方价是标价最低那款的 33 倍。决定实付价的是「官方价 × 卖家折扣」两个乘数,只看一个必然算错。
下文所有价格单位是美元 / 百万 token,实付价 = 官方价 ×(1 − 买家折扣)。折扣取自平台模型广场当时的挂单,数据截至 11 月 19 日。
看最直接的一组对比。gpt-oss-20b 官方输入价 $0.03,是全站标价最低的文本模型,但只有 5 折,实付 $0.015。gpt-6.1-terra 官方价 $1,是它的 33 倍,却打到 97.03% off,实付 $0.0297——只贵一倍。
反过来的例子更值得记住。qwen3.7-max 官方价 $1.79 看着温和,报价停在 5 折,实付 $0.896;gpt-6-astra 官方价 $10,是全站最贵的标价之一,折扣 99.01% off,实付 $0.099,只有前者的九分之一。
所以判断「便宜」只需要一条:有没有卖家把价格压到 9 折以下(折扣率 90% 以上)。停在 5 折的模型,官方价再低实付也下不来;能压到 1 折以内的,旗舰也能当量产的耗材用。
| 模型 | 官方输入价 | 最高折扣 | 实付输入价 | 10 美元可买 |
|---|---|---|---|---|
| gpt-oss-20b | $0.03 | 50% off | $0.015 | 约 6.67 亿 |
| gpt-6.1-terra | $1 | 97.03% off | $0.0297 | 约 3.37 亿 |
| deepseek-v4.1-flash | $0.2987 | 89% off | $0.0329 | 约 3.04 亿 |
| gpt-6-sol | $2 | 98.35% off | $0.033 | 约 3.03 亿 |
| gemini-3.8-flash | $0.75 | 92.3% off | $0.0578 | 约 1.73 亿 |
| glm-5.3-flash | $0.1195 | 50% off | $0.0598 | 约 1.67 亿 |
| gpt-6-astra | $10 | 99.01% off | $0.099 | 约 1.01 亿 |
| glm-5 | $0.597 | 50% off | $0.2985 | 约 3350 万 |
| qwen3.7-max | $1.79 | 50% off | $0.8958 | 约 1116 万 |
| gpt-5.5 | $5 | 56% off | $2.2 | 约 455 万 |
表里十行按实付价从低到高排。注意 gpt-5.5:官方价 $5 只有 56% off,实付 $2.20,是这十个里最贵的,10 美元只够 455 万 token。同一个平台里,最贵和最便宜差 147 倍。
token 数不直观,换成「一次请求」更好判断。取一个典型任务:输入 3000 token(约 2000 字中文稿加系统提示),输出 1000 token(约 700 字回答),按实付价算单次成本。
| 模型 | 单次成本 | 10 美元可跑 | 输出 / 输入价倍数 |
|---|---|---|---|
| gpt-oss-20b | $0.000110 | 约 90,909 次 | 4.3 倍 |
| gpt-6.1-terra | $0.000238 | 约 42,088 次 | 5.0 倍 |
| deepseek-v4.1-flash | $0.000230 | 约 43,474 次 | 4.0 倍 |
| gemini-3.8-flash | $0.000462 | 约 21,645 次 | 5.0 倍 |
| gpt-6-astra | $0.000792 | 约 12,626 次 | 5.0 倍 |
| glm-5 | $0.002240 | 约 4,465 次 | 4.5 倍 |
| qwen3.7-max | $0.005376 | 约 1,860 次 | 3.0 倍 |
两个观察。第一,输出价比输入价贵 3 到 5 倍,写作、长回答类任务的账单主要由输出决定——把回答压短一半,比换一个模型更见效。第二,便宜档之间的真实差距远小于官方价的差距:gpt-oss-20b 和 gpt-6.1-terra 官方价差 33 倍,单次成本只差一倍多。
稳定性也得一起看,下面这组数字来自同一次健康接口返回:近 24 小时 gpt-5.6-terra 约 4600 次调用、成功率 99.76%、P50 耗时约 8.6 秒;deepseek-v4.1-flash 约 3200 次、成功率 95.19%、P50 约 8.3 秒、输出速度 61 token/s。数据截至 11 月 19 日,这类数字每天都在动,选型时以页面实时值为准。
冲量档(批处理、打标签、摘要):gpt-oss-20b 配 glm-5.3-flash。前者实付 $0.015 / $0.065,后者 $0.0598 / $0.209,后者带 104 万上下文、3 个卖家 2 个认证,适合成批的长文摘要。10 美元按上面的短请求算,约能跑 9 万次和 2.5 万次。
均衡档(对外产品、日常问答):gpt-6.1-terra($0.0297 / $0.1485,97.03% off,4 个卖家 1 个认证)或 gpt-6-sol($0.033 / $0.165,98.35% off,7 个卖家 2 个认证)。10 美元分别约 4.2 万次、3.8 万次,能力比冲量档高一档,单价只高约 1.5 倍。
旗舰档(难题、长文推理、代码评审):gpt-6-astra,官方 $10 / $50,99.01% off 后 $0.099 / $0.495,9 个卖家 2 个认证,是全站卖家最多的模型。10 美元约 1.26 万次短请求,或 1.01 亿输入 token。
组合原则:八成请求走冲量档,两成走均衡档,旗舰档只留给真正难的活。按 8 : 2 加权计算,10 美元大约覆盖 8.1 万次短请求——每月 8000 次的内部测试量可以跑十个月。
坑一,只看输入价。qwen3.7-max 输入 $0.896、输出 $2.6886,一次短请求的成本是 gpt-oss-20b 的 49 倍;按输入价排序会严重低估这个差距。
坑二,忽略长上下文阶梯。gpt-6-astra 和 gpt-5.5 在输入超过 27.2 万 token 后,输入价翻倍($10 到 $20、$5 到 $10),输出涨 50%。做长文档任务,10 美元的购买力会直接腰斩,具体档位可以在 模型广场 的模型卡片里核对。
坑三,卖家少、没有实测。gpt-oss-20b 只有 1 个卖家、没有认证,报价虽低但没有真实调用记录可参考;gpt-5.5 也是 1 个卖家 0 个认证,实付 $2.20 却垫底。生产环境优先选卖家多、带认证的档位,价格贵一点换的是可用性。
三步就能落地:先在广场按「实付价」而不是官方价筛出 3 个候选;再用自己的真实 prompt 各跑 20 次,看返回的 usage 和输出质量;最后按 8 : 2 的比例配两档模型。完整价格对照在 价格页。
最后提醒一句:卖家挂单和折扣每天都在变,本文数字是 11 月 19 日的快照,下单前请以页面实时报价为准。
上下文能装一百万字,不代表按这个价收费。超过 27.2 万 token 输入价翻倍,qwen3.6-plus 过 25.6 万直接 4 倍。本文列出七个在售模型的真实档位与四条避坑做法。
OpenAI发布GPT-6.2并把旗舰价下调20%,阿里、腾讯同周把单任务成本和缓存价压到新低。结论:官方降价仍远高于本站实付价,gpt-6-astra现在最深0.099折,实付$0.099/百万输入token。日常用现款便宜档,追新等上架比价。
大模型缓存token是什么?一句话:把重复的提示词前缀存下来,命中后按缓存读计价,通常只有正常输入价的5%到12%。本文用在售模型的真实缓存价,讲清缓存读写怎么算钱、什么情况命中,以及怎么把账单压下来。
Claude 有哪些模型?站内 12 个版本按实付价排完发现:最新的 opus-5-5 月成本 $8.91,最老的 opus-4-6 反而 $49.50。本文给出全系价格表、真实实测数据与四个场景的选型结论,日常开发选 sonnet-5-5 最稳。
写代码用哪个 AI 模型?按本站实付价和 24 小时实测:gpt-5.6-terra、deepseek-v4.1-flash 各三千多次调用零失败,每月千次请求分别 $2.85 和 $1.66;gemini-3.8-flash 出字 111 token/s 最快。附完整实付价表与三档选型建议。
 LONG AI