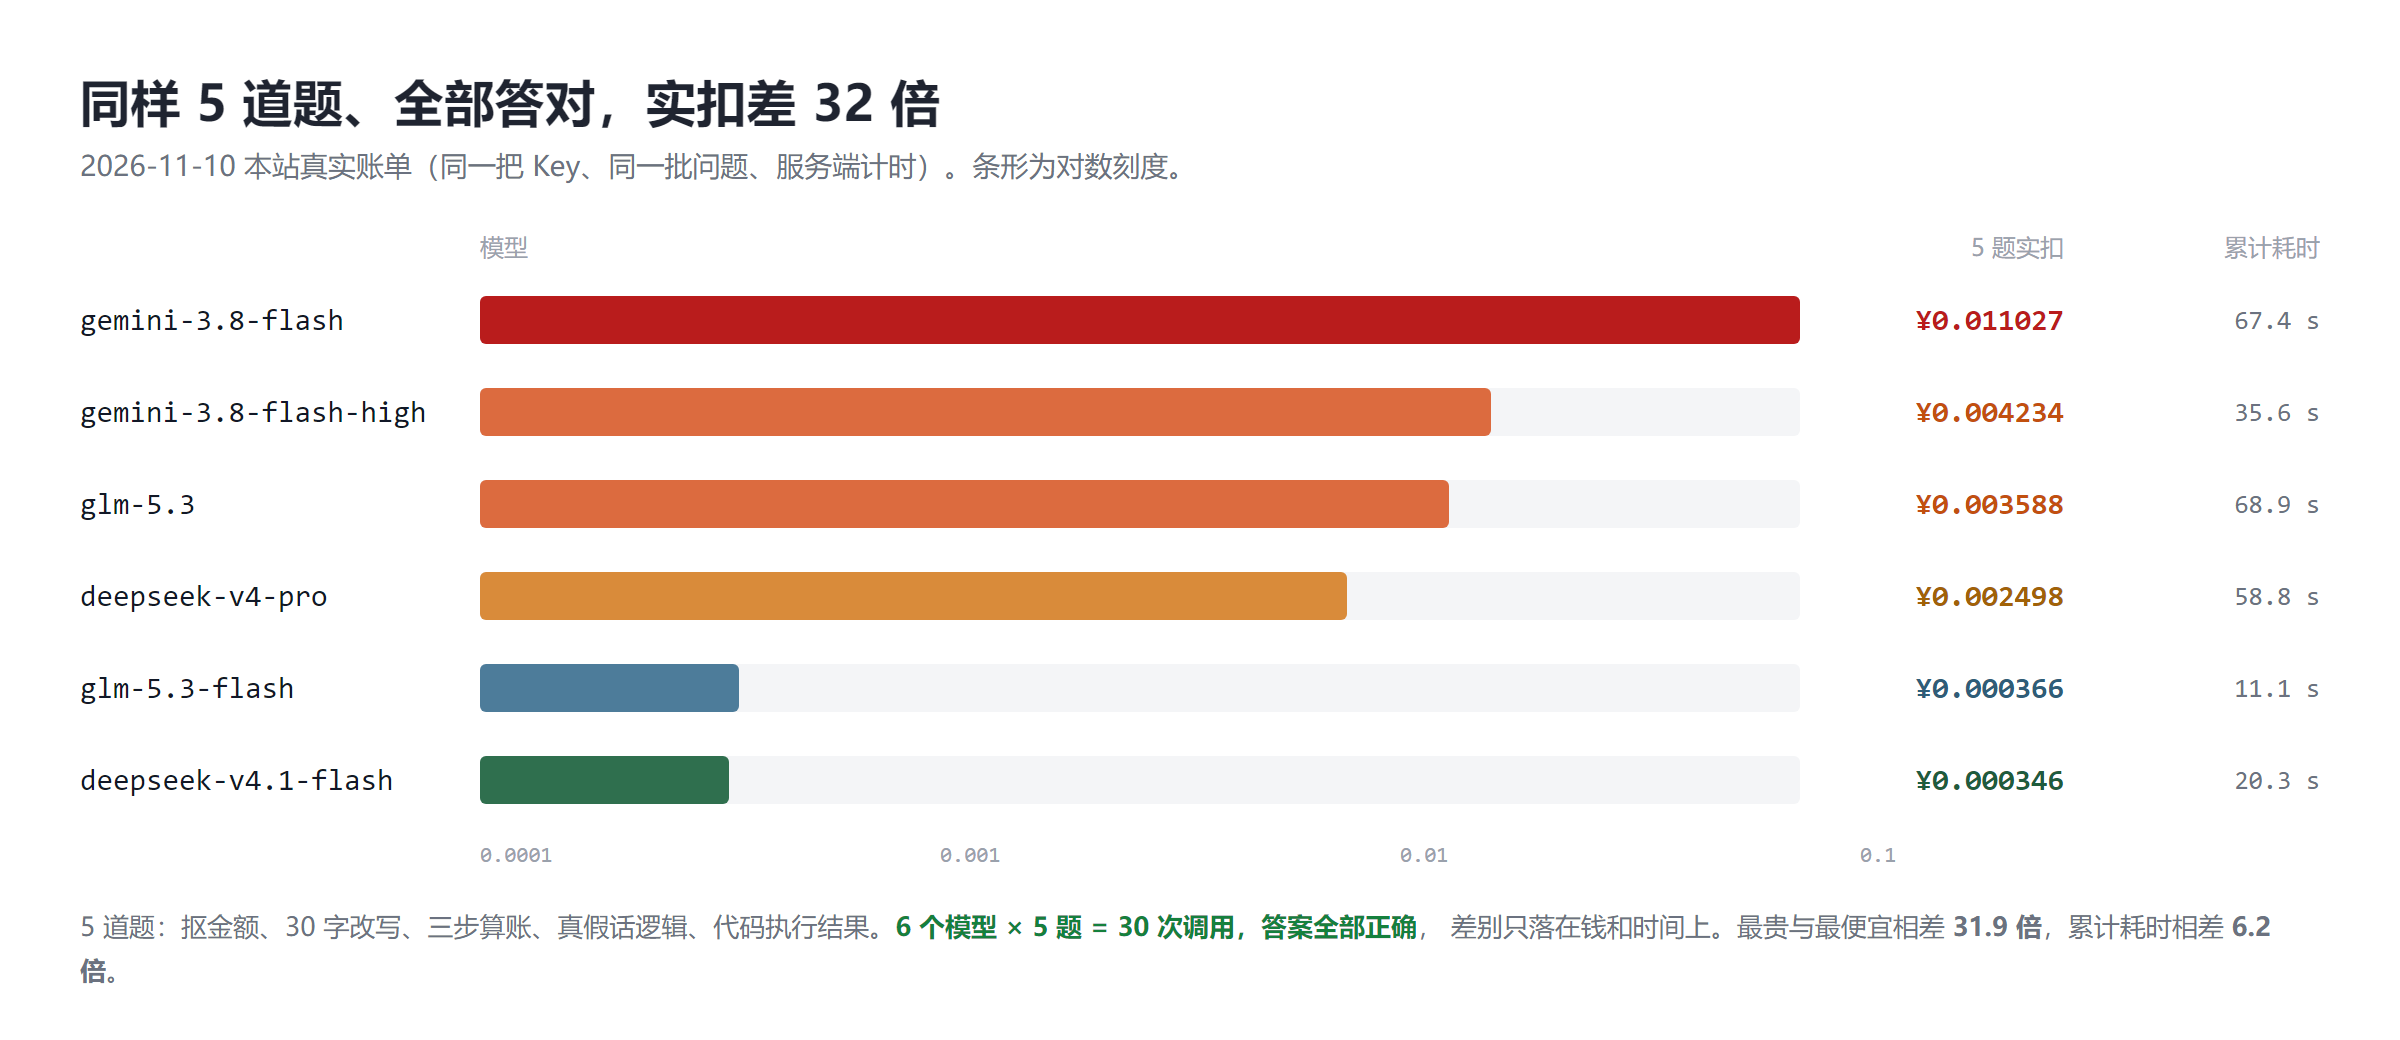
结论先说:6 个模型跑同一批 5 道日常题,30 次调用全部答对,最贵实扣 0.011027 元、最便宜 0.000346 元,差 31.9 倍。我又补了 3 道"看着必须动脑"的题(24 点、12 球天平、9 步连算),还是全对。在我测的这批题里,多付的钱买到的是更多看不见的思考 token 和更长的等待,不是更准的答案。
口径:同一把 Key、同一批提示词、不设 temperature;耗时取本站服务端记录,金额取使用记录里的实扣,不是按单价估算。模型名都能在 模型广场 搜到,价格以模型广场实时价格为准。
| 模型 | 5 题实扣(元) | 累计耗时 | 答对 |
|---|---|---|---|
| gemini-3.8-flash | 0.011027 | 67.4 s | 5 / 5 |
| gemini-3.8-flash-high | 0.004234 | 35.6 s | 5 / 5 |
| glm-5.3 | 0.003588 | 68.9 s | 5 / 5 |
| deepseek-v4-pro | 0.002498 | 58.8 s | 5 / 5 |
| glm-5.3-flash | 0.000366 | 11.1 s | 5 / 5 |
| deepseek-v4.1-flash | 0.000346 | 20.3 s | 5 / 5 |
题目:抠应付金额、30 字改写、三步算账、真假话逻辑、读代码结果。
差距最大的是改写题:
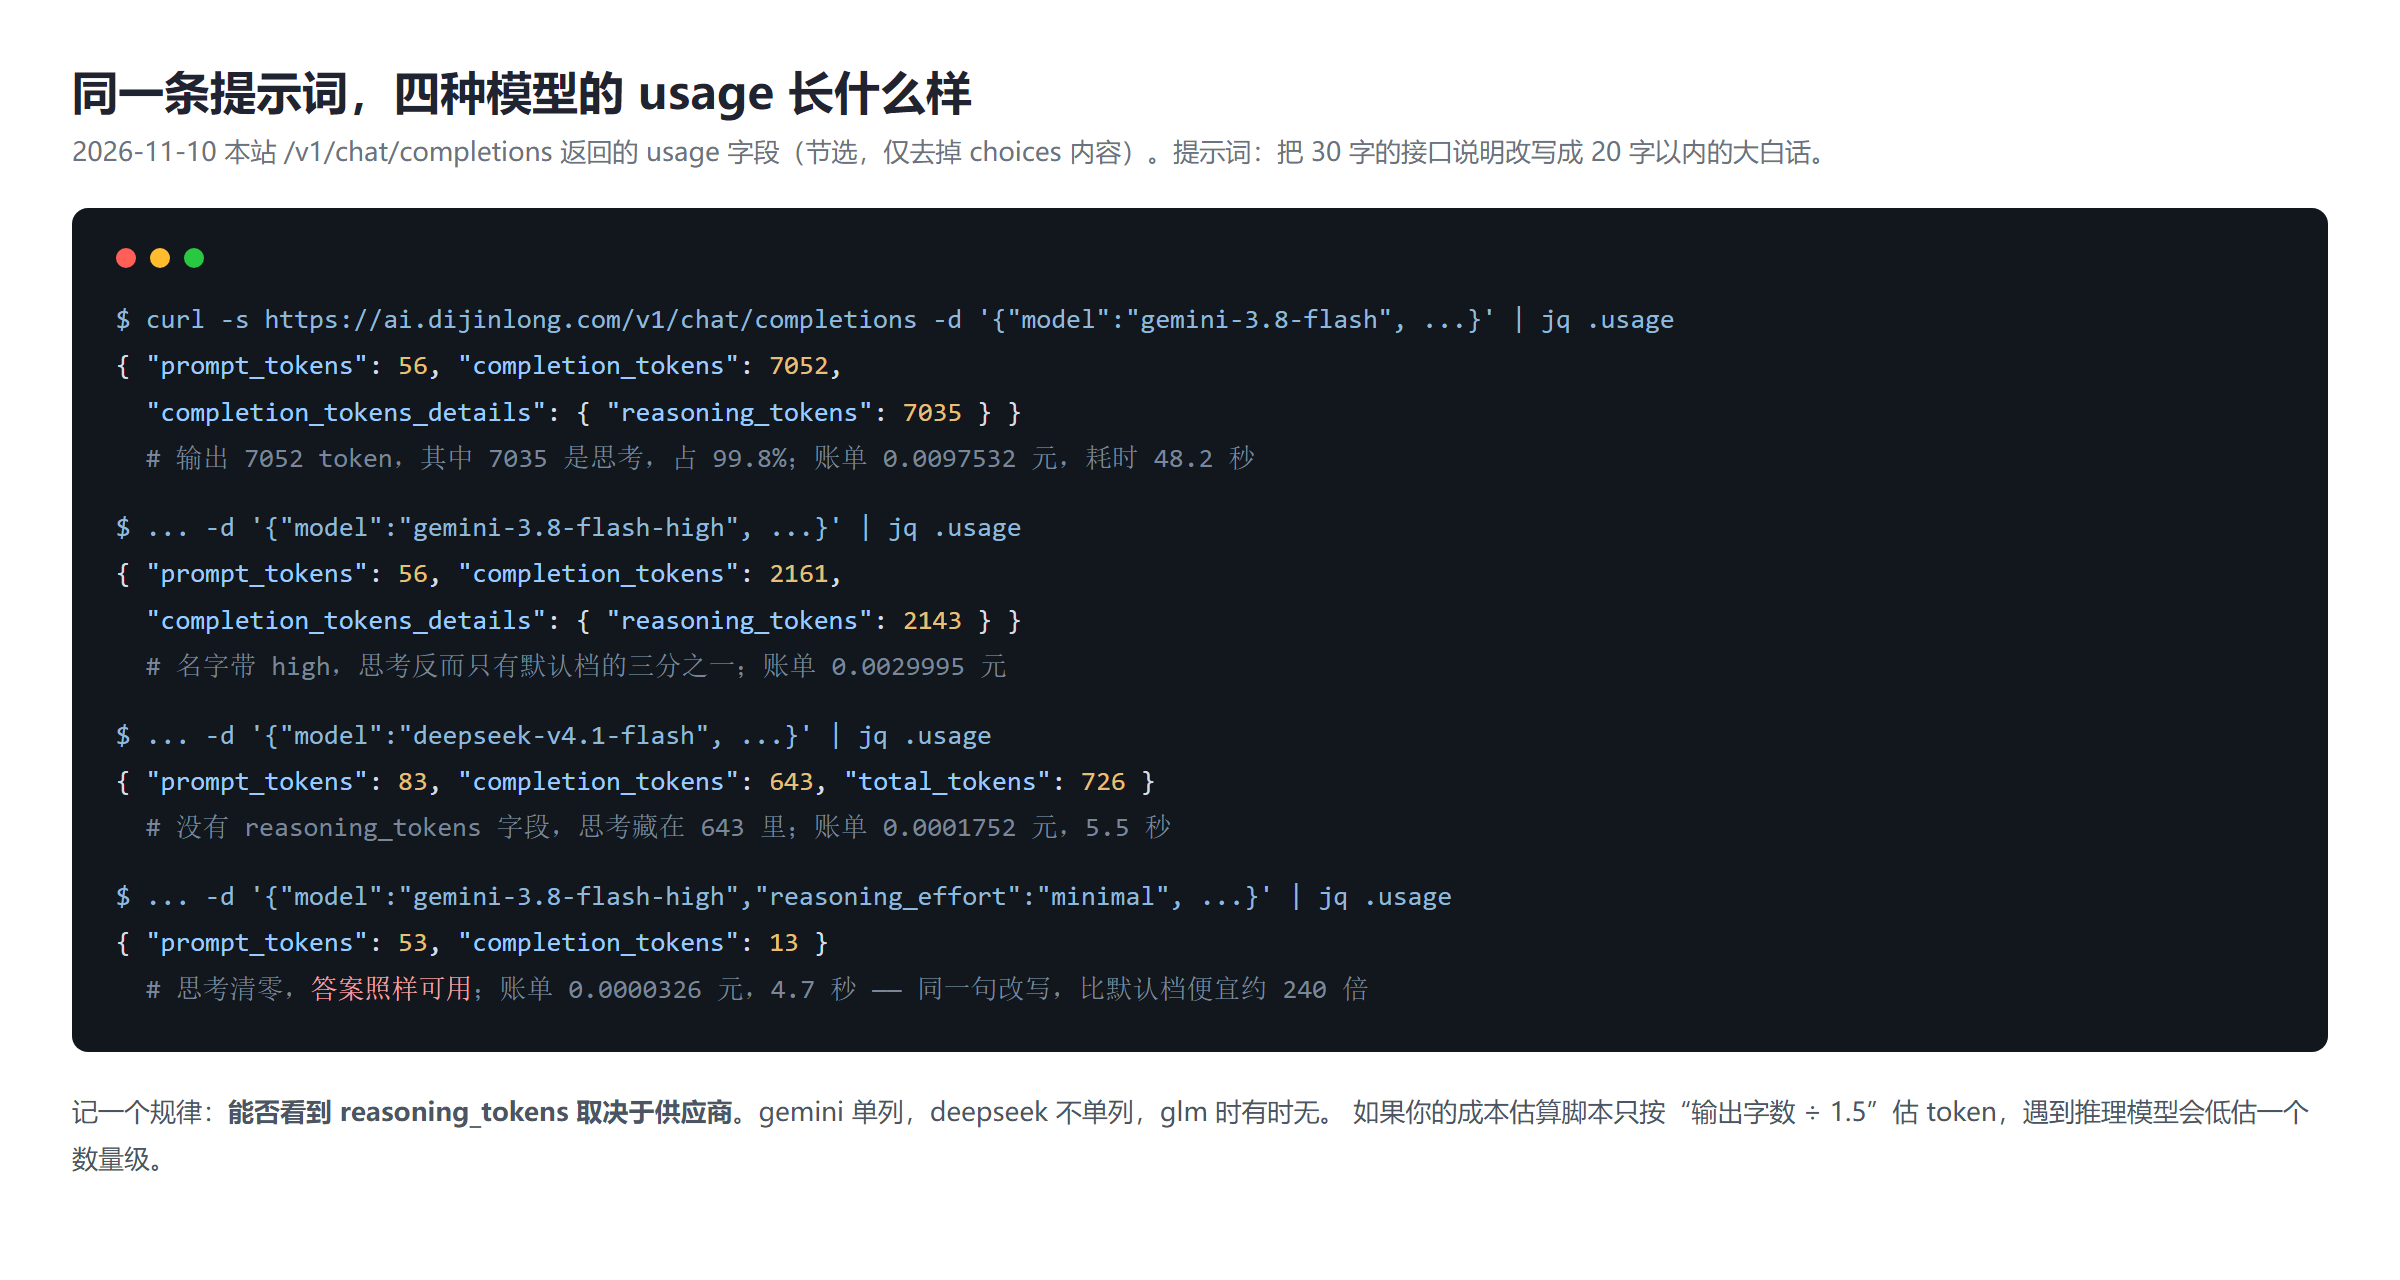
两个答案都能用。钱差 55.7 倍、时间差 8.8 倍,换来的只有措辞上的差别——用错地方最典型的形态不是效果差,是没有任何收益的纯支出。
同一题输出 7052 个 token,其中 7035 个是 reasoning_tokens,正文只吐了十几个字。思考按输出价计费,而输出价通常是输入价的 5 倍。
还有更隐蔽的口子:输入侧。同一句 88 字的问题,glm-5.3-flash 这一笔记了 7437 个输入 token,同题的 glm-5.3 只有 76 个。模型自带的系统提示、工具定义都按输入价收钱——那一题 glm-5.3-flash 实扣 0.000336 元,glm-5.3 只有 0.000167 元。单价便宜十倍,账单反而更贵。
推理模型都留了思考预算的口子,只是参数名各家不同,写错了不报错、被静默忽略、钱照收。同一句改写题按不同参数各跑两遍,数字稳定复现:
| gemini-3.8-flash-high 的参数 | 输出 token | 耗时 | 实扣(元) |
|---|---|---|---|
| reasoning_effort = minimal | 13 ~ 14 | 4.7 s | 0.0000326 ~ 0.0000339 |
| reasoning_effort = low | 17 ~ 18 | 3.4 ~ 7.8 s | 0.0000381 ~ 0.0000395 |
| reasoning_effort = high | 2289 | 17.0 s | 0.0031754 |
| 不传参数(默认) | 5701 | 44.7 s | 0.0078868 |
| reasoning_effort = medium | 7858 | 53.4 s | 0.0108653 |
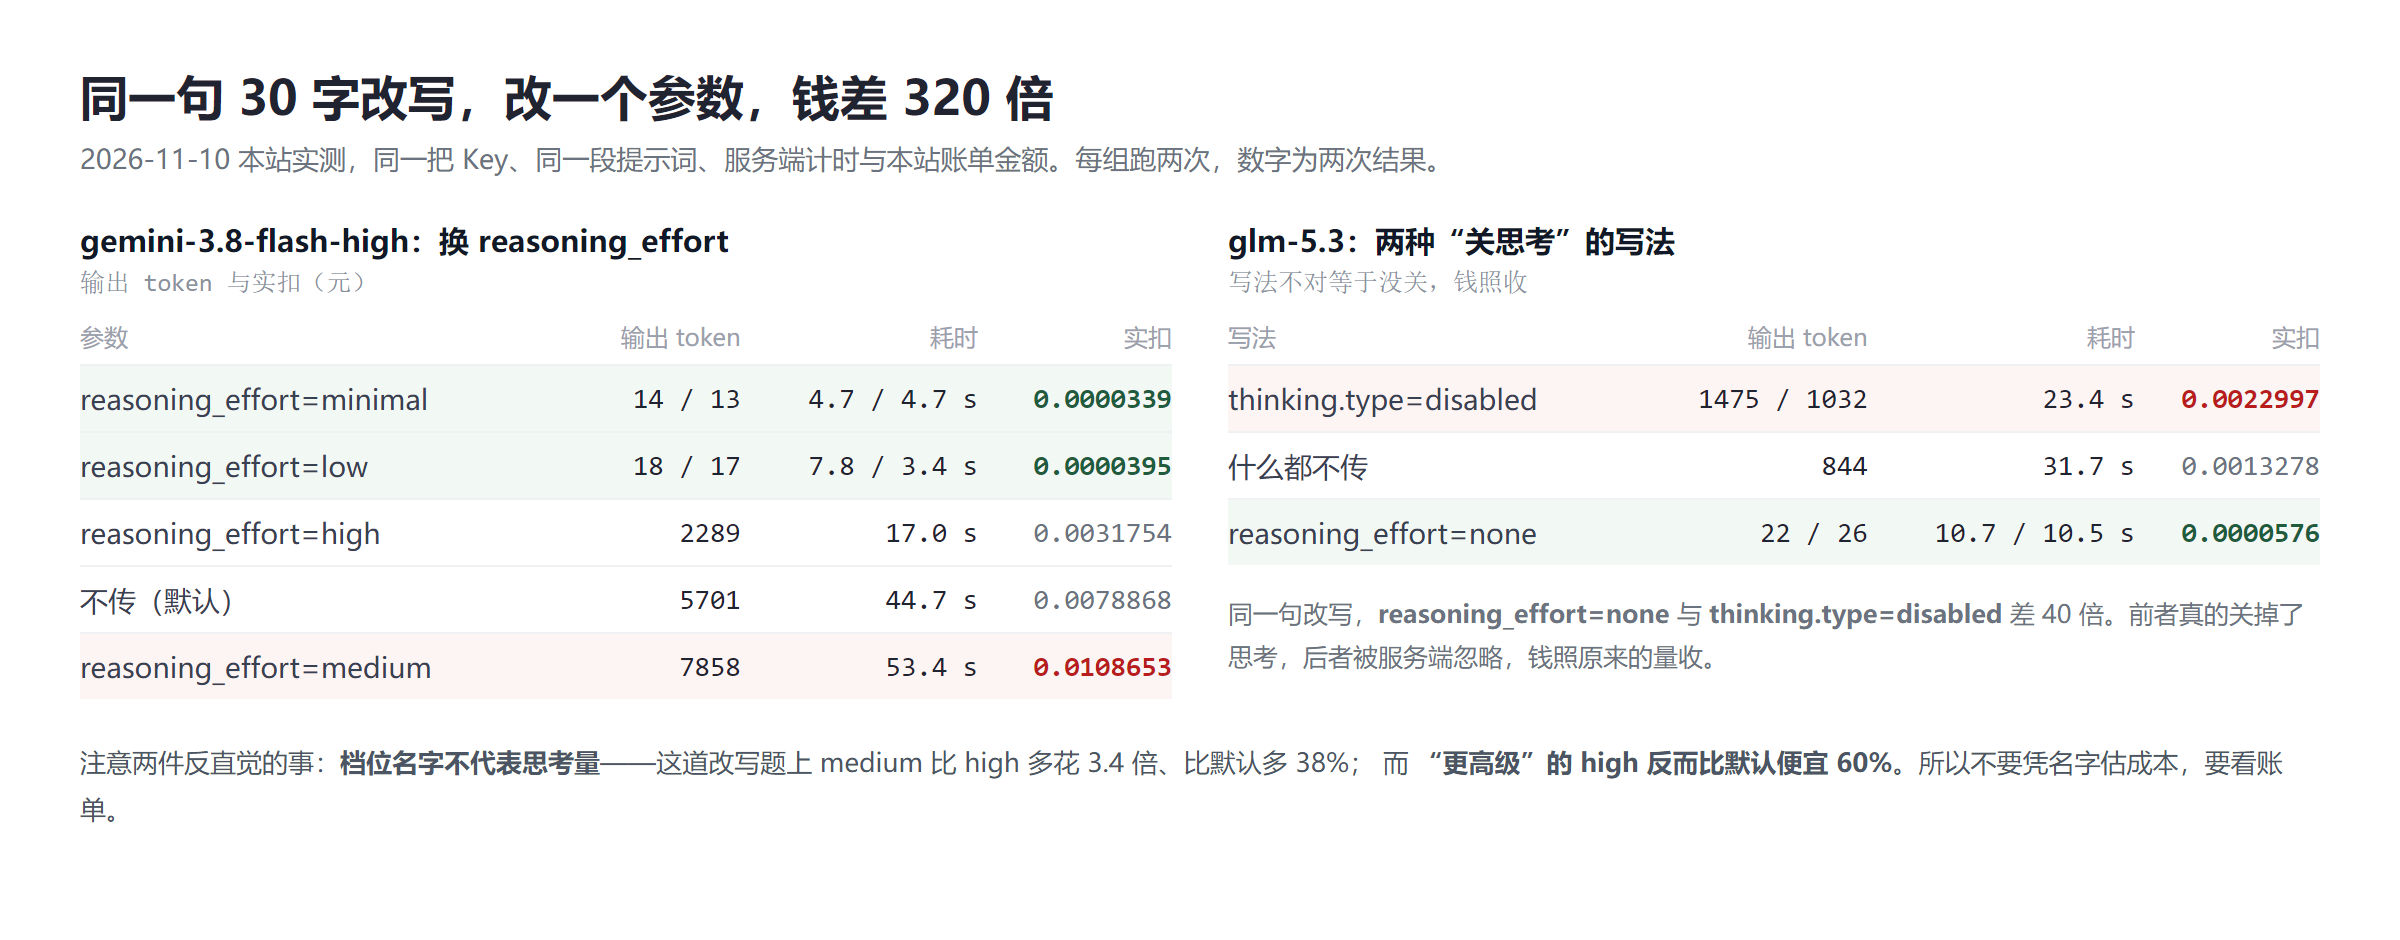
两个反直觉的地方:
thinking: {"type":"disabled"} 无效,输出 1475 个 token、实扣 0.0022997 元;换成 reasoning_effort: "none" 才真关掉,22 个 token、0.0000576 元,差 40 倍。gemini 认的是 minimal / low。所以别信文档,传完看返回的 usage:输出 token 掉到个位数,才算真关掉了。
3 道题:用 3、3、8、8 凑 24(答案 8/(3-8/3))、12 球不知轻重最少称几次(3 次)、9 步连算(237)。一个都没翻车。deepseek-v4.1-flash 用 81 个 token、2.4 秒答对连算,24 点题 111 个 token、5.5 秒。
反倒是 deepseek-v4-pro,同一道 24 点花了 503 个 token、10.7 秒,实扣贵 14 倍,答案一样。所以"看着难"不能当作开推理的理由;真正拉开差距的是长链条、多约束、要反复自我校验的任务,只能拿自己的题去试。
为什么是 10 条:单条可能是运气,要重复三次看稳定性。价格以 模型广场 实时报价为准,同一模型不同卖家折扣不同。
1)为什么 completion_tokens 比答案字数多几十倍?
思考 token 按输出计费,但多数供应商不把思考过程放进正文。gemini 单列 reasoning_tokens,deepseek 只有 reasoning_content、token 并在 completion 里,glm 时有时无。看到 7052 而正文 20 字,正常。
2)设了 max_tokens 为什么还是慢或答案被截断?
思考也算在 max_tokens 预算内。预算给小了,模型想着想着就用完,正文吐不出来。留预算要比预期正文宽 3~5 倍。
3)传了关思考的参数,账单为什么没降?
参数名不对就被忽略。判断办法只有一个:看返回 usage 的输出 token 有没有掉下来。glm-5.3 认 reasoning_effort=none、不认 thinking.type=disabled,这是 11 月 10 日实测结果。
4)输入 token 为什么比我的提示词长那么多?
模型自带的系统提示、工具定义、格式约束都算输入。这一批里同一句话见过 76 和 7437 两种输入 token,按字数估成本的脚本必须拿账单校准。
5)便宜模型偶尔答错怎么兜?
先跑便宜档,命中明显失败信号(输出为空、JSON 解析失败、答"无法确定")再升级到推理档重跑一次。95% 请求走便宜链路,只有 5% 付贵的钱。一个 Key 下怎么切模型,见 站内文档。
本文金额都是 2026-11-10 的真实扣费,价格随卖家和促销变动,下单前以模型广场实时价格为准;模型更新后思考的默认行为也可能改,自测建议每季重跑一次。
OpenAI发布GPT-6.2并把旗舰价下调20%,阿里、腾讯同周把单任务成本和缓存价压到新低。结论:官方降价仍远高于本站实付价,gpt-6-astra现在最深0.099折,实付$0.099/百万输入token。日常用现款便宜档,追新等上架比价。
大模型缓存token是什么?一句话:把重复的提示词前缀存下来,命中后按缓存读计价,通常只有正常输入价的5%到12%。本文用在售模型的真实缓存价,讲清缓存读写怎么算钱、什么情况命中,以及怎么把账单压下来。
Claude 有哪些模型?站内 12 个版本按实付价排完发现:最新的 opus-5-5 月成本 $8.91,最老的 opus-4-6 反而 $49.50。本文给出全系价格表、真实实测数据与四个场景的选型结论,日常开发选 sonnet-5-5 最稳。
写代码用哪个 AI 模型?按本站实付价和 24 小时实测:gpt-5.6-terra、deepseek-v4.1-flash 各三千多次调用零失败,每月千次请求分别 $2.85 和 $1.66;gemini-3.8-flash 出字 111 token/s 最快。附完整实付价表与三档选型建议。
拿到密钥后把 API 地址改成平台地址,就能用一个 Key 调用在售的 138 个模型(覆盖 51 家厂商),同时兼容 OpenAI 和 Anthropic 两种请求格式。本文给出可直接复制的接入代码、模型切换方法和常见坑,全部接口已实测验证,数据截至 11 月 16 日。
 LONG AI