DeepSeek 开源 Super-agent 架构:任务完成时间砍半,AI 学会自己管自己
本栏目每天汇总近 1–2 天全球新发布 / 新开源的大模型,信息来自官方公告与多家媒体交叉核验;性能数据会区分「官方口径」和「已复测 / 第三方实测」,没复测的明确标注。配图为原创示意插画。
今日最重磅:DeepSeek 开源 Super-agent 架构(10 月 31 日晚)
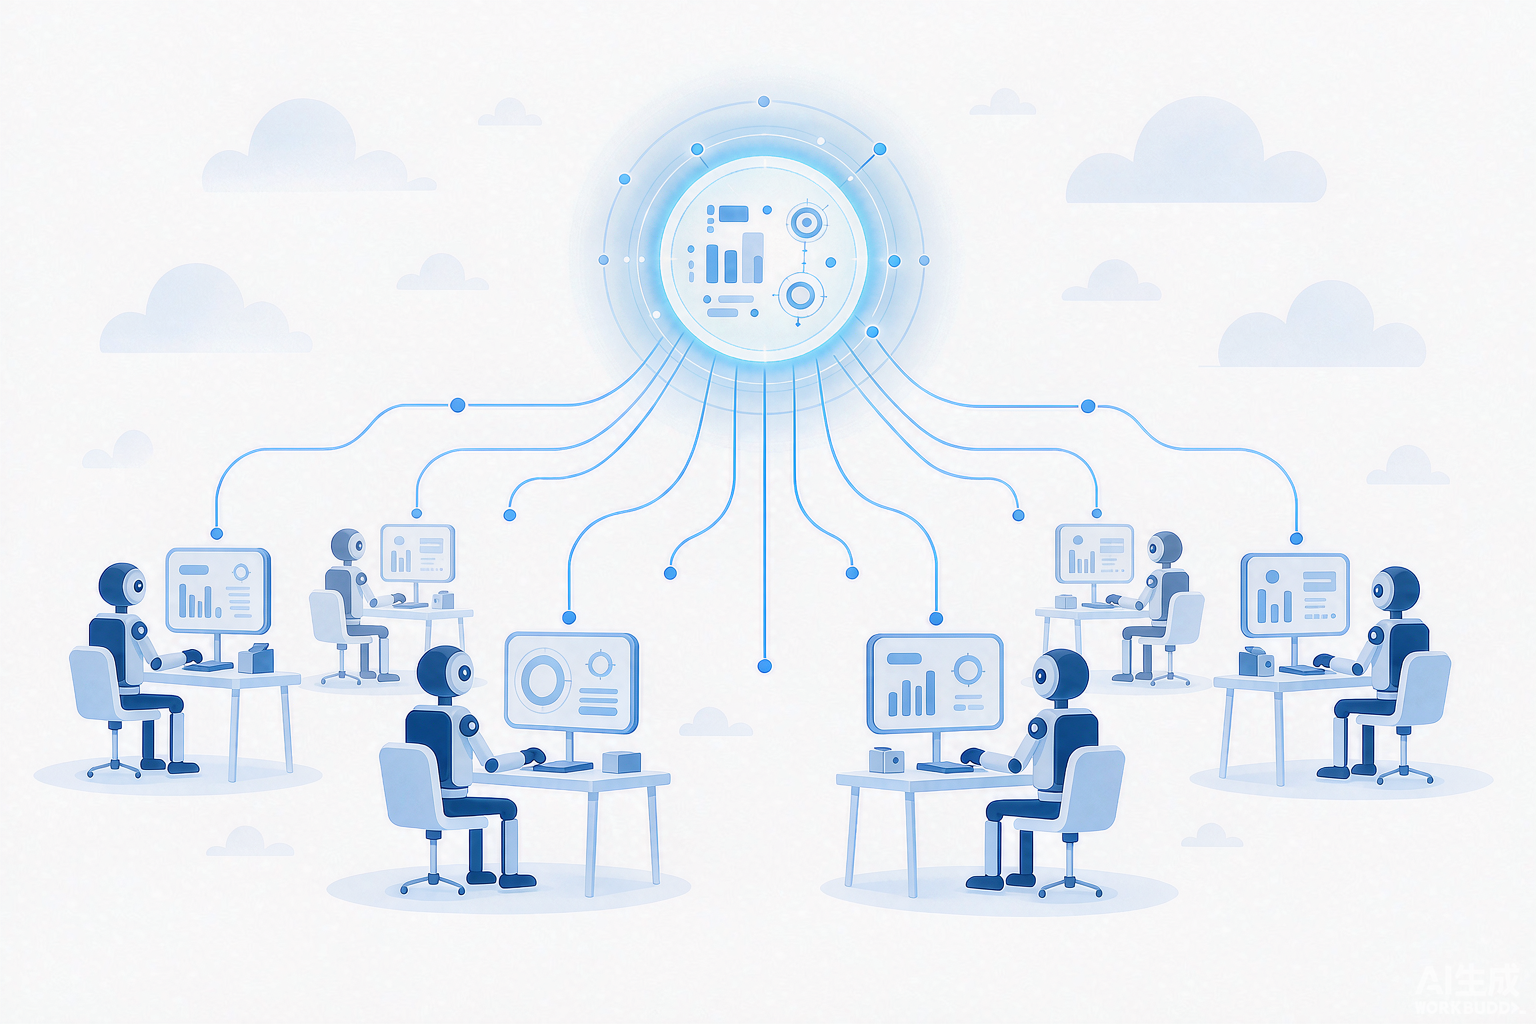
DeepSeek Harness 团队 10 月 31 日晚在官方公众号发表技术文章《Super-agent 设计探索:迈向更自主的 Agent 系统》,同步把可运行的原型开源到 GitHub(dsh-superagent-prototype,MIT 协议)。它不是一款新产品,而是一份面向工程实践的架构蓝图,回答一个很实际的问题:AI 完成单个任务已经不用人盯了,但一个人同时只能跟住 3–5 个活跃会话——多任务的上限,正在从「模型能力」变成「人的注意力」。
DeepSeek 的解法,是把计算机系统几十年的老手艺搬进 Agent 架构:
- 双层架构「脑手分离」:常驻的 Router(调度员)统一接收群聊、GitHub、邮件等多渠道消息、维护全局上下文、分派任务,自己不动手;Worker(执行者)各自隔离上下文、并行干活,可以用最强模型,必要时再叫 Subagent。人只对着一个助手说话,身后几个会话同时推进。
- 事件驱动,不用人 @:群聊消息先用程序规则快筛(快路径),剩下的再交给大模型语义判断要不要行动(慢路径)——所以群里有人报 bug 但没人 @ AI,它也会自己在后台复现、找修复方案。同一个 GitHub PR、同一个话题的后续事件直接「订阅直通」给对应 Worker,不再层层过 Router。
- 存算分离 + 外部看门狗:计算逻辑在云端、会话状态独立保存,本地设备离线也不影响任务推进;独立的 Watchdog 会话盯着所有 Worker,发现卡死就尝试自愈。
数字:官方口径任务完成时间砍掉近一半
在包含约 300 条消息、20 项工作请求的模拟协作环境里(官方自述实验,合成环境、简化负载、每种配置只跑 5 次,团队自己标注「初步参考」):Super-agent 任务完成时间中位数 12.4 分钟、95 分位 15.7 分钟;传统单会话方案在中性提示下是 20.4 / 29.5 分钟——p95 快了近一半。另外,订阅直通机制给 Router 省了约 37% 的 Token 开销,批处理把单个决定分摊的推理时间从 6.4 秒压到 1.6 秒。团队也老实交代了账单的另一面:读的缓存 Token 比单会话方案更多。
DeepSeek 说,基于这套思路的内部实例已经在日常研发中持续运行,参与问题复现修复、代码审查响应和 Harness 自身迭代。怎么看:当各家还在卷「模型再聪明一点」时,DeepSeek 把力气花在了「系统层接管调度」——如果这条路线跑通,Agent 产品的形态会从「对话框」变成「常驻后台的同事」。架构是开源的,成色如何,等社区把原型跑起来见分晓。
今日其他新发布(3 项)
| 模型 / 产品 | 日期 | 类型 | 要点 |
|---|---|---|---|
| SenseNova Loop-9B-Preview(商汤,开源,Apache 2.0) | 10-30 官宣,11-1 报道扩散 | 多模态 LLM(循环架构) | 主打「加深计算,不堆参数」:32 层权重存 9B,中间 24 层用共享权重连跑两遍,一次前向等于 56 层计算(推理量约 14.6B),再配上 mHC 双流残差机制稳住信号。官方口径办公与智能体任务超 Qwen3.5-27B(WorkBuddy Bench 66.89、BIRD-Dev 71.38),但 Terminal-Bench 2.1(40.45)输给 Qwen3.6-27B 的 47.19;全部自报未复测,技术报告尚未发布。训练上下文 262K。 |
| Pika H3 Flex(Pika,开源权重 + API) | 10-29 发布,11-1 中文集中报道 | 音视频联合生成 | 基于 MiniMax H3 后训练的「迭代专用」版本:两套 LoRA 适配器(文生/首尾帧 FL2VA、多模态参考 Ref2VA,一次最多 12 个参考文件),蒸馏到 6 步去噪(教师模型 50 步),原生 480P/768P、最长 15 秒带同步立体声;API 还能把音频拆成对白/配乐/音效/拟音/环境声五条轨。官方口径 DesignArena 文生视频榜第八、开源视频模型第一;「15 秒 768p 只需 7 秒计算」为受控基准口径,未复测。11-2 起进 Pika 消费端。 |
| PixelUMM(英伟达 × 滑铁卢大学,开源) | 论文 9-29 挂 arXiv,11-1 报道开源落地 | 统一多模态(理解 + 生成) | 把多模态模型的「标配双编码器」全砍了:不要 ViT、不要 VAE,图像切 16×16 块、视频切 4 帧时空块,一层线性投影直接把原始像素接进 Qwen3-8B 主干,理解和生成共享注意力。视频理解在统一模型里四项基准最高(MVBench 70.53),文生视频 VBench 83.24,GenEval 0.77——论文自述与先进基线「相当」而非碾压;代码与权重已在 GitHub / HuggingFace 开放。短板也直白:MMMU 综合推理 41.67,明显落后专用 VLM;高 CFG 下平滑区域有网格伪影。 |
另:MiniMax 为 M3.1 Flash(428B)追加发布了低比特量化版权重,官方强调经过精细校准而非简单取整,让同一套权重能跑进更多本地硬件(11-1/2 报道)。
行业资讯
- 乌镇峰会今天开幕(11-2 至 11-5):主题就是「开源开放 共建共享」,全国首个开源主题生态体验馆 11-1 已开馆。展台风向:阿里展示灵骏真武 M890 超节点,中兴推全球首款 AI 智能体手机,而腾讯展台写的是「开源新一代大语言模型」——正好接住下面这条。
- 腾讯官宣 Hy4 全面升级(10-31 数字生态大会):混元 Hy4 Preview(770B-A49B、1M 上下文,8 月底开源)将强化长程与真实生产力任务、提升思维链效率,并首次引入视觉理解;主打性价比的 Hy4 flash 近期发布。叠加阿里「Qwen4 next week」的现场转述,11 月的国产双旗舰对决正式排上日程(两家的日期都还不是官宣,等实锤)。
- OpenAI 两件事(10-31):一是 12 月起 ChatGPT 与 Codex 共享订阅额度,把 Work 的智能体能力并进主界面;二是据多家媒体报道,新一轮融资目标从 300 亿美元下调至 200 亿(估值 1.25 万亿美元)——资本市场的耐心在降温,与标普同日把 Meta 评级展望下调至负面(AI 投入回报的不确定性)互相印证。
- Meta 找中国厂商代工机器人(The Information,11-1 报道):Meta 与傅利叶合作的人形机器人原型 Max,三个月出原型:身高约 1.5 米、48 公斤、搭载英伟达 Thor,定位 Muse 模型的「物理化身」;双方 9 月已启动 Max 2 研发。美国头部 AI 公司用中国本体供应链跑速度,具身赛道的分工格局值得盯。
- 人形机器人首批 6 项国家标准发布:覆盖环境感知、决策规划、运动控制、作业操作、仿真测试等核心环节,2027 年 4 月 1 日起实施——行业从讲故事进入交付验收阶段,评测口径统一后,裸泳者要现形了。
- Anthropic 订阅改名(10-31):200 美元档 Max 20x 更名 Ultra,100 美元档更名 Max,价格不变——为上市(NASDAQ 代码 ANT)理顺品牌的前奏。
- 前瞻日历:11-4 前 Kimi K3.1 Pro 完整权重开源(官宣节点);11-5 前后谷歌 / Meta 按历史节奏的新发布窗口(AI Release Tracker 预测口径,仅供参考);11-12 百度世界大会(文心新一代,六家里唯一官宣日期);DeepSeek 下一次发布预测在 11 月下旬。
一句话趋势
今天的关键词是「往下挖」:DeepSeek 动的是 Agent 的系统层,商汤动的是 Transformer 的层数,英伟达动的是多模态的编码器——参数竞赛降温之后,大家开始在同一件事上加注:用更聪明的结构,而不是更大的规模,把单位算力的产出再拧出一截。下周 Qwen4、Hy4、Kimi 权重扎堆落地,规模与结构两条路线很快会同台对账。
(数据来自官方公告与公开报道,2026-11-02;官方口径与第三方实测已分别标注,未复测项已在文中说明。模型能力强弱会影响选型,但实际价格以本站模型广场实时报价为准。)