API 报 429 怎么解决?5 个真原因与排查顺序
结论先说:429 不是「你代码写错了」,是「现在没资源给你」。但同样是 429,背后有五种完全不同的原因——前两种等一会儿就好,后三种要你去后台改设置。分不清就去加重试,只会白等。
我用真实 Key 在我们站复现了三种 429,并拉了 30 天错误日志做归因。报错原文、统计数字、退避代码都在下面,换别家 API 中转站,判断方法一样适用。
一、先看数字:七成 429 不是你的问题
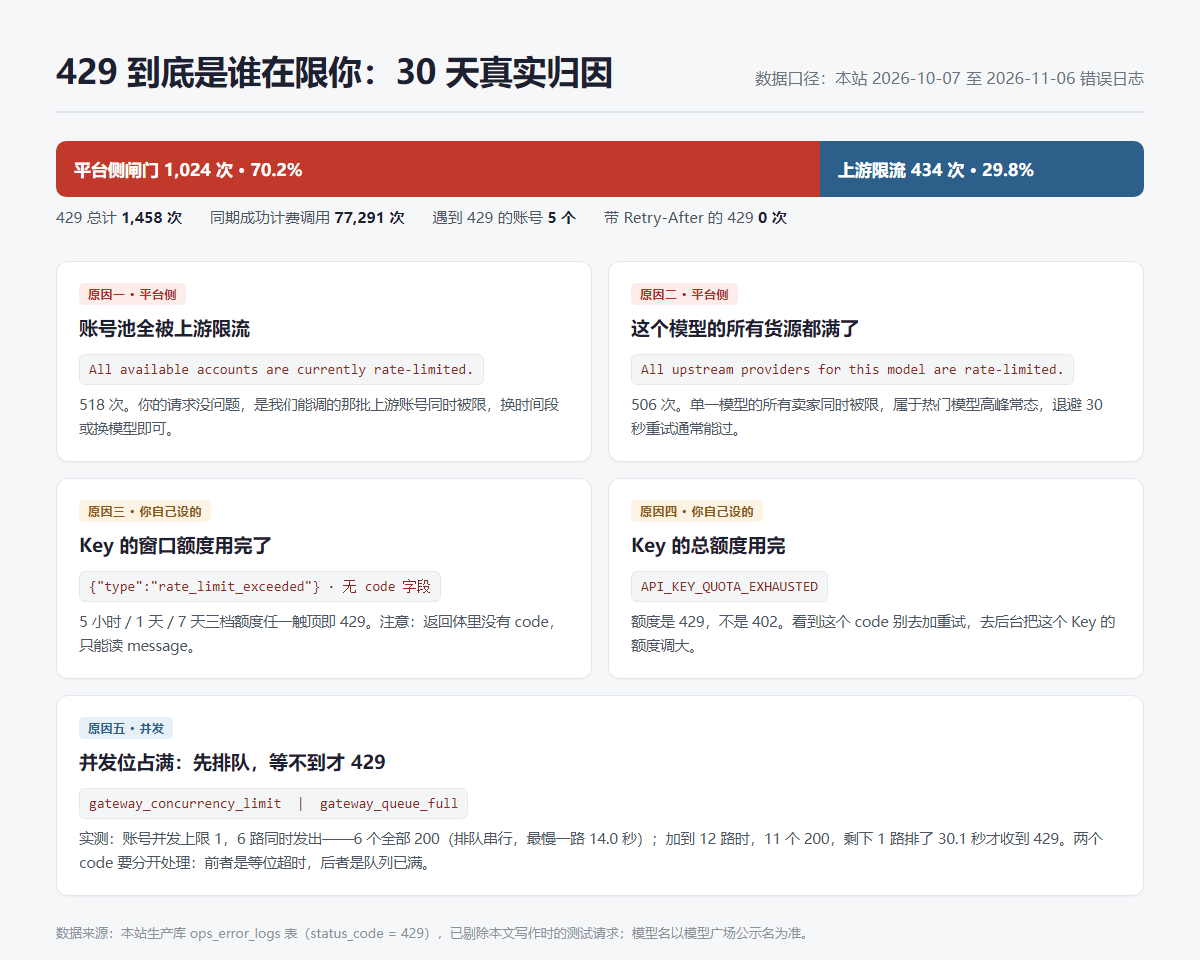
2026-10-07 到 11-06 这 30 天,我们站记录在案的 429 一共 1,458 次,同期成功计费调用 77,291 次。按来源劈开:平台侧闸门 1,024 次(70.2%),上游直接返回 434 次(29.8%)。
另一个数字更该记住:这 1,458 次 429 里,带 Retry-After 响应头的是 0 次。所以别写「读 Retry-After 决定等多久」的代码,等不到,退避时间只能自己算。
二、三种 429 的原始返回,长得完全不一样
同一个账号、同一个 Key 组、同一个模型 deepseek-v4.1-flash,2026-11-06 我用 curl -D- 抓了三段完整响应:
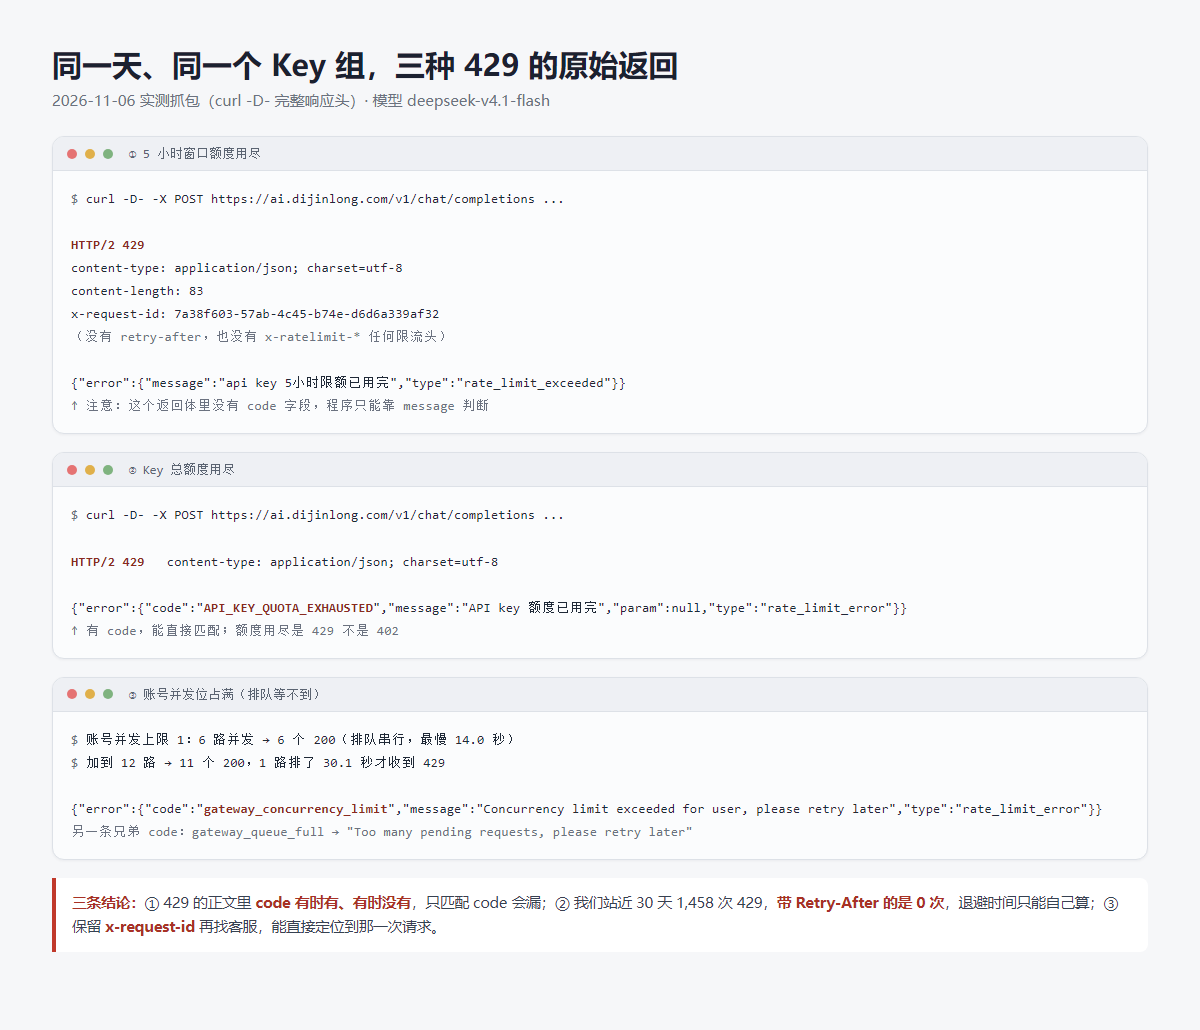
最坑的是第一种:返回体里没有 code 字段,只有一句中文 message 加一个笼统的 type。你要是按 error.code 做分支判断,这种情况直接漏判,然后误判成「上游抽风」开始无脑重试。
三、五个真原因,对号入座
原因 1:平台账号池被你赶上了(518 次)
原文是 All available accounts are currently rate-limited。意思是我们能调的那批上游账号同时被限,跟你写的代码无关。换个时间段,或者换一个同价位的模型,通常立刻好。
原因 2:这个模型的所有货源都满了(506 次)
原文是 All upstream providers for this model are rate-limited。热门模型的高峰常态,属于供给不足。实测最集中的三个:kimi-k2.6(77 次)、claude-fable-5(60 次)、claude-opus-5-5(25 次)。
原因 3:Key 的窗口额度用完了
Key 可以设 5 小时、1 天、7 天三档额度,任意一档触顶就是 429,文案是「api key 5小时限额已用完」。这条最容易误判:它跟账户余额没关系,加了钱也不会好,必须去改这个 Key 的额度设置。
原因 4:Key 的总额度用完了
code 是 API_KEY_QUOTA_EXHAUSTED。同样,额度是给单个 Key 设的天花板,充值不会自动放宽。看到这个 code 别加重试次数,去后台调额度。
原因 5:并发位占满——先排队,等不到才 429
这条最反直觉。实测:账号并发上限是 1,我同时发 6 路请求,6 路全部返回 200——因为它们在排队串行跑,最慢一路等了 14.0 秒。加到 12 路时,11 路成功,剩下 1 路在原地排了 30.1 秒才收到 gateway_concurrency_limit。另一个兄弟 code 是 gateway_queue_full,表示队列本身就满了。
所以「我并发 10 就 429」和「我并发 100 也没事」都可能是真的,取决于那一秒排不排得上。
四、两分钟定位:按这个顺序看四处
- 看 body 有没有
code:有就照 code 判;没有就看 message 里是不是含「限额」。 - 看 message 是中文还是英文:中文基本是我们拦的(额度、并发),英文基本是上游回的。
- 看后台这个 Key 的额度:5 小时、1 天、7 天、总额度四项,任何一项见底就是它。
- 看你自己当时的并发数:同一刻在跑的请求有几个。
一条命令就能把上面四项信息里的前三项一起拿到:
curl -D- -o body.txt -X POST https://ai.dijinlong.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $KEY" \
  -d '{"model":"deepseek-v4.1-flash","max_tokens":8,"messages":[{"role":"user","content":"hi"}]}'
顺便说一句:如果状态码是 401 或 404、502,那不是限流,别在这篇里找答案,去看这三种报错的责任划分。
五、重试怎么写才不把自己打死
一个前提:额度类 429 重试一万次也没用,因为它不会自己恢复。所以先分类,再退避:
import random, time, requests

QUOTA_CODES = {"API_KEY_QUOTA_EXHAUSTED"}          # 改额度才有用
CONC_CODES  = {"gateway_concurrency_limit", "gateway_queue_full"}

def call(payload, key, tries=4):
    for i in range(tries):
        r = requests.post("https://ai.dijinlong.com/v1/chat/completions",
                          json=payload, headers={"Authorization": "Bearer " + key}, timeout=120)
        if r.status_code != 429:
            return r
        err = r.json().get("error", {})
        code = err.get("code") or ""
        msg  = err.get("message", "")
        if code in QUOTA_CODES or "限额" in msg:      # 额度问题:立刻停,去后台改
            raise RuntimeError("额度用尽,重试无意义:" + msg)
        if code in CONC_CODES:                        # 并发问题:先降并发,再退避
            time.sleep(1)
            continue
        time.sleep(min(60, 2 ** i) + random.uniform(0, 1))   # 其余按指数退避 + 抖动
return r实测一个细节:被 429 拒掉的请求不扣钱。我那三个探针 Key 一共吃了 6 次 429,账单里一次都没记;成功调用的 19 次里,最便宜的一次只花了 0.000041 元。所以别为了「省钱」而不重试——成本压力不在这里。
六、什么时候该换模型,而不是继续重试
给你一条可执行的分界线:同一个模型连续 3 次 429,且每次间隔都超过 30 秒,就换模型。间隔 30 秒还在 429,说明不是瞬时抖动,是容量问题,再等就是浪费时间。
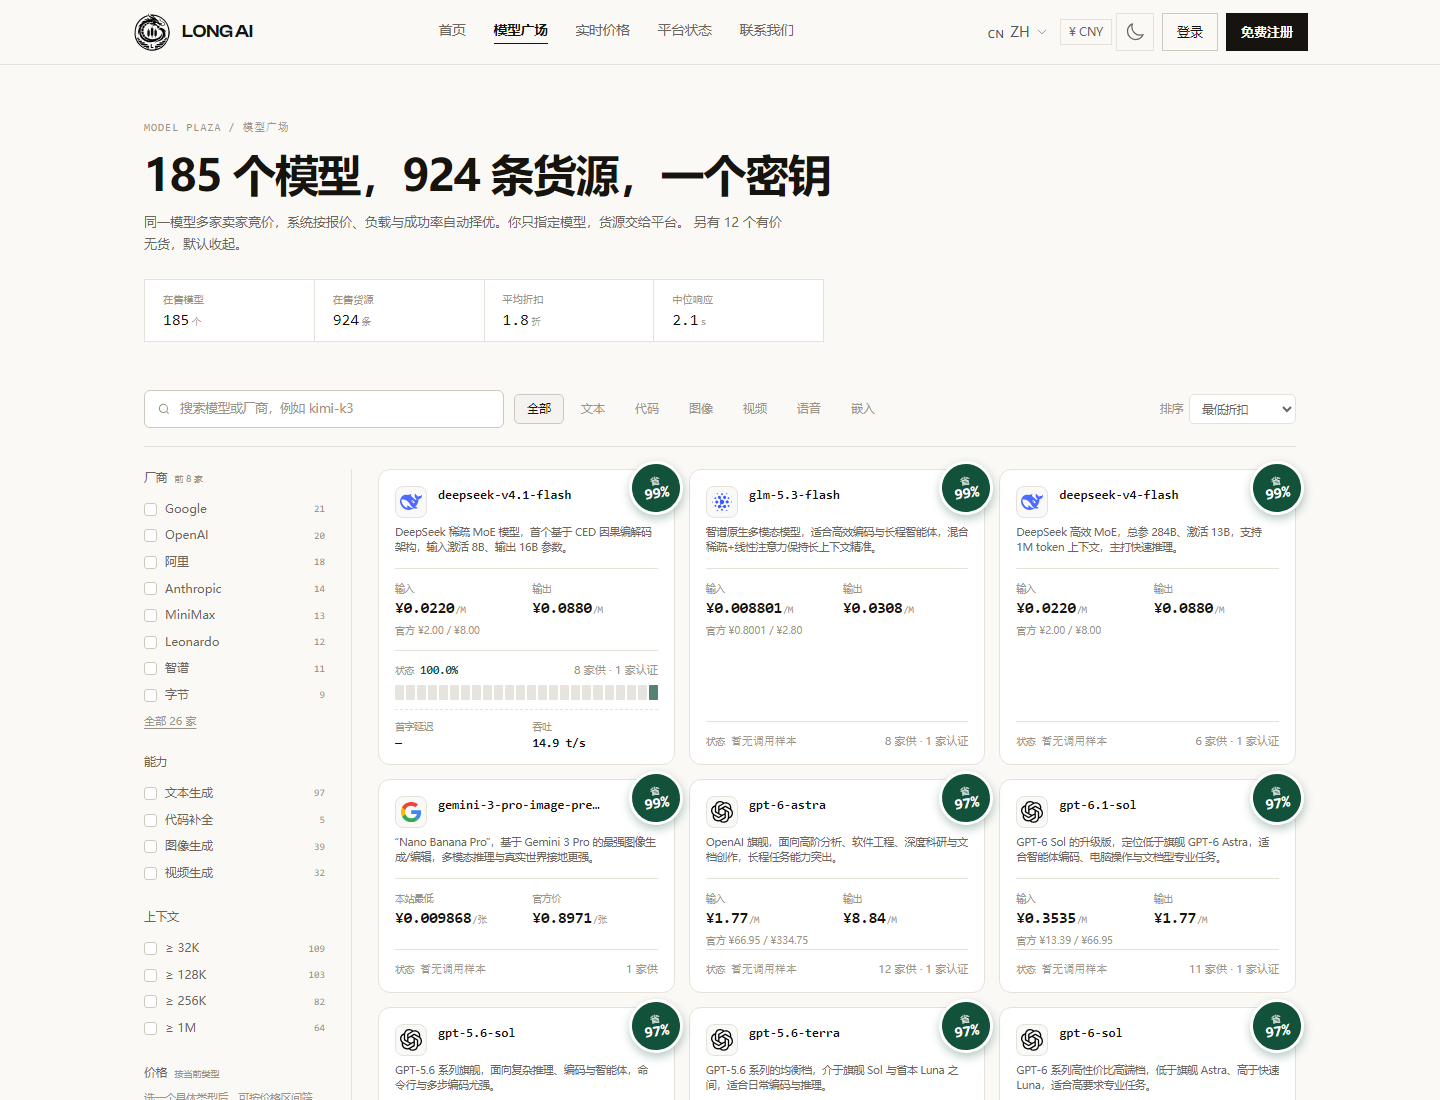
换哪个?去模型广场看实时价格和每个模型的货源条数,同价位一般能找到 2 到 3 个可替换的。目前广场上是 185 个模型、924 条货源:
反过来,503 更该换模型。同期 503 有 13,625 次,是 429 的 9 倍多——503 的意思是「这个模型此刻没有可用上游」,等是等不来的。
七、常见问题
429 会扣钱吗?
不会。被拒的请求没有产生 token,我们这边也没有计费记录(上面的 6 次 429 实测为 0)。
充了钱为什么还是 429?
大概率是额度没改:余额是账户的,额度是 Key 的。去后台把这个 Key 的四项额度调大,或直接把限额清零。
Postman 里好好的,代码里一直 429?
先查并发。实测 6 路并发在并发上限 1 的账号上会被排成串行,最慢一路等 14 秒。循环里发请求时用信号量限一下并发,比加退避更有效。
429 和 503 我该等还是该换?
429 等(30 秒起步、指数退避);503 换(换模型或换时间)。判据是状态码和 code,不是感觉。
找客服要给什么信息最快?
响应头里的 x-request-id。上面那条 curl 已经把它打出来了,报障时贴这一行,能直接定位到那一次请求。
最后一句:429 是「暂时没资源」,不是「你被封了」。分清是哪一种,比写十行重试代码有用。价格和可用性以模型广场实时价格为准,本文数据抓取于 2026-11-06。